3秒でわかるこの記事の要点
- 生成AIの利用は「何を入力してよいか」の線引きがないまま広がりやすい
- データを機密度で分類し、入力可否のルールを先に決めることが出発点になる
- 保存先・学習利用・ログ保持の扱いはサービスごとに違うため規約で確認する
業務で生成AIを使う場面が急速に広がるなかで、「その入力データをどこまで社内で認めてよいのか」というルール整備が追いついていない組織は少なくありません。便利だからと現場が先行して使い始め、後から情報システム部門や法務が慌てて対応する、という順序になりがちです。この記事では、生成AIの社内利用ルールをどう作るかを、入力データが抱えるリスクの整理から、データの分類、ルールに盛り込む項目、整備の進め方まで、公開されている一次情報をもとに実務目線で整理します。
- なぜ生成AIの社内利用ルールが必要なのか
- 何を判断基準にデータを分類し、入力の線引きをするか
- ルールに盛り込む項目と整備の進め方
なぜ生成AIの社内利用ルールが必要なのか
生成AIは、検索や翻訳のような一般的なツールと同じ感覚で使われがちです。ただし、入力した情報がどこへ送られ、どう扱われるかはサービスによって異なります。ルールがないまま利用が広がると、判断が個人任せになり、組織として説明できない状態が生まれます。まずは、入力データにどのようなリスクがあるのかを共通認識にすることが出発点です。
入力データが抱えるリスク(漏洩・学習利用・越境移転)
生成AIへの入力データに関わるリスクは、大きく3つに分けて考えると整理しやすくなります。
- 漏洩: 入力した機密情報や個人情報が、意図しない形で外部に出る可能性
- 学習利用: 入力内容がサービス側のモデル改善に使われ、他者への出力に影響し得る可能性
- 越境移転: データが海外のサーバーで処理・保存され、国外へ移転される可能性
このうち学習利用については、多くのサービスで入力データを学習に使わない設定や オプトアウト 用語解説 サービス側の既定の扱いに対し、利用者が「使わない」よう申し出て除外すること。生成AIでは入力データの学習利用を停止する設定を指すことが多い。 の仕組みが用意されていますが、既定の扱いや適用範囲はサービスや契約プランによって異なります。無償版と法人向けプランで前提が違うことも多く、「一律に安全」とは言えません。実際の可否は各サービスの利用規約やデータ取り扱いポリシーで確認する必要があります。
越境移転については、個人データを含む場合、国内の法制度上の論点になり得ます。個人情報保護委員会は外国にある第三者への個人データ提供に関するガイドラインを公表していますが、個別の処理が越境移転に当たるか、どの要件が適用されるかは取り扱いの実態によって判断が分かれます。
出典: 個人情報保護委員会「個人情報の保護に関する法律についてのガイドライン(外国にある第三者への提供編)」。適用の可否は取り扱いの実態により異なります。
※ 本記事は一般的な整理であり、法的助言ではありません。個別のデータ処理が法令上どう扱われるかは、契約形態やデータの内容によって異なるため、法務確認を前提にしてください。
ルール不在で起きがちな問題
ルールがない状態では、現場が良かれと思って業務効率化のために機密情報を入力してしまう、といった事態が起こり得ます。禁止一辺倒にすると、今度は会社が把握していないところで無断利用が広がる シャドーIT 用語解説 情報システム部門の管理外で、従業員が独自に導入・利用するツールやサービスのこと。把握できないため統制やセキュリティ上の課題になりやすい。 を招きます。
とりあえず全面禁止にしておけば、リスクは避けられますか?
禁止だけでは逆効果になりがちです。 把握できない無断利用を招くため、使える範囲を示すルールとセットで考えます。
問題が起きたときに「誰が・どのデータを・どのサービスに入力したか」を後から追えないことも、ルール不在の大きな弱点です。事故対応や再発防止の観点からも、あらかじめ利用の枠組みを決めておく意味があります。
何を判断基準にするか:データの分類
利用ルールを「サービス単位」で考えると、新しいサービスが出るたびに判断がぶれます。より安定するのは、扱うデータの機密度を軸に線引きする考え方です。何を入力してよいかは、サービスの知名度ではなく、そのデータが漏れたときの影響で決めるほうが一貫します。
機密度でデータを分類する
多くの組織では、情報資産をいくつかの機密度に分類しています。生成AIの利用ルールも、この既存の分類に接続すると現場が理解しやすくなります。
機密度による分類の例
公開情報
すでに外部公開されている情報。入力のハードルは低い。
社内限定情報
社外秘だが特に機微ではない情報。利用条件を付けて許容する範囲。
機密・個人情報
顧客情報、個人情報、契約情報など。入力の可否を慎重に判断すべき範囲。
分類は一般的な整理例です。実際の区分や名称は、各組織の情報セキュリティ規程に合わせて調整します。
入力してよい情報/避けるべき情報の線引き
分類ができたら、それぞれで入力の可否を決めます。判断に迷う場面をあらかじめ想定し、現場が自分で線引きできるチェック観点を用意しておくと運用しやすくなります。
- その情報は公開済みか、社外に出ると困る情報か
- 個人情報や顧客情報が含まれていないか
- 契約上、第三者への提供や社外持ち出しが制限されていないか
- 入力データが学習に使われない設定・契約になっているか
個人情報や顧客から預かった情報は、たとえ便利でも安易に入力しない、という原則を明文化しておくと判断がぶれにくくなります。どうしても業務で必要な場合は、匿名化やマスキングを前提にする、といった条件付きの運用を検討します。
利用ルールに盛り込む項目
リスクとデータ分類を踏まえて、具体的なルールに落とし込みます。ここでは「どのサービスを・どこまで・どう使ってよいか」を明文化することがねらいです。
利用可能なサービス・利用範囲の定義
すべての生成AIサービスを一律に扱うのではなく、会社として利用を認めるサービスをあらかじめ定める方法があります。法人向けプランなど、データの取り扱い条件が明確なサービスに絞ることで、確認すべき論点を減らせます。
- 利用可能なサービス: 会社が契約・許可したサービスの一覧を示す
- 用途の範囲: 文章作成、要約、翻訳など認める業務を具体的に示す
- 承認プロセス: 新しいサービスを使いたい場合の申請・確認の流れを決める
データの取り扱い(保存先・学習利用・ログ保持)の確認
利用を認めるサービスについては、データがどう扱われるかを規約ベースで確認します。特に次の3点は、サービスや契約プランで前提が変わりやすいため、時点を明記して記録しておくと後から追いやすくなります。
サービス選定時に確認したい取り扱い
保存先・処理場所
データがどの国・リージョンで処理・保存されるか。越境移転の有無に関わる。
学習利用の有無
入力データがモデルの学習に使われるか。オプトアウトの可否と既定の扱い。
ログ保持・アクセス
入力内容がどの程度の期間保持され、誰がアクセスし得るか。
取り扱いの条件は各サービスの利用規約・データ取り扱いポリシーに従います。内容は改定され得るため、確認した時点(例:2026年7月時点)を控えておくと運用しやすくなります。
ルール整備の進め方(チェック観点)
ルールは一度作って終わりではなく、現場に浸透し、実態に合わせて見直せる状態を目指します。整備の進め方は、おおむね次のような順序で考えると着手しやすくなります。
- 現状把握: すでに社内で使われているサービスと用途を洗い出す
- 方針決定: データ分類と入力可否の原則を決め、関係部門で合意する
- ルール明文化: 利用可能なサービス・範囲・禁止事項を文書化する
- 周知・教育: なぜそのルールなのかを含めて現場に説明する
- 見直し: サービスの規約変更や新サービスに応じて定期的に更新する
ルールを守ってもらうには、禁止事項を並べるだけでなく、「なぜ入力してはいけないのか」という理由をあわせて伝えることが効果的です。理由が腑に落ちれば、想定外のケースでも現場が自分で判断しやすくなります。
国内で処理が完結する基盤という選択肢
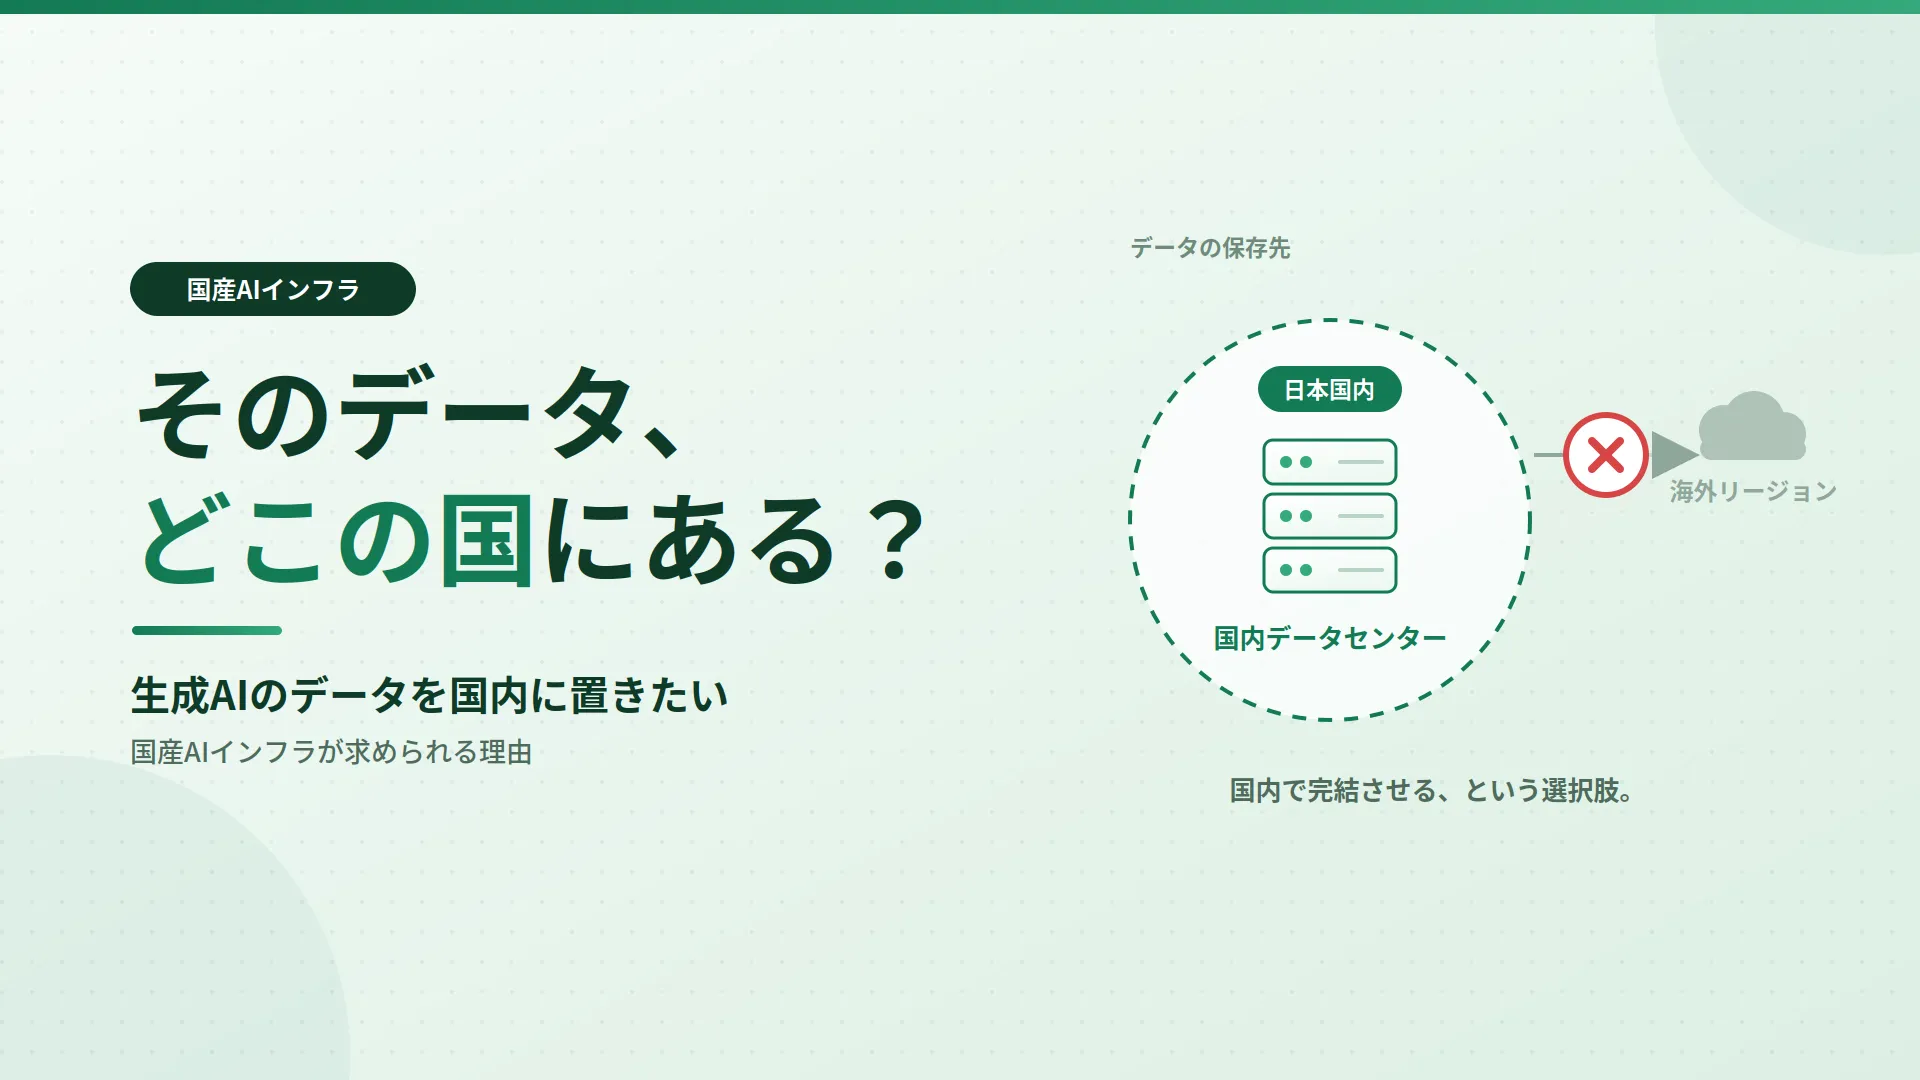
ここまでは、既存のサービスをどう使うかという運用面のルールを整理してきました。一方で、そもそも扱うデータを海外に出さずに済む基盤を選ぶ、という選択肢もあります。国内でデータの処理が完結する構成であれば、越境移転そのものを避けやすくなり、確認すべき論点を減らせます。
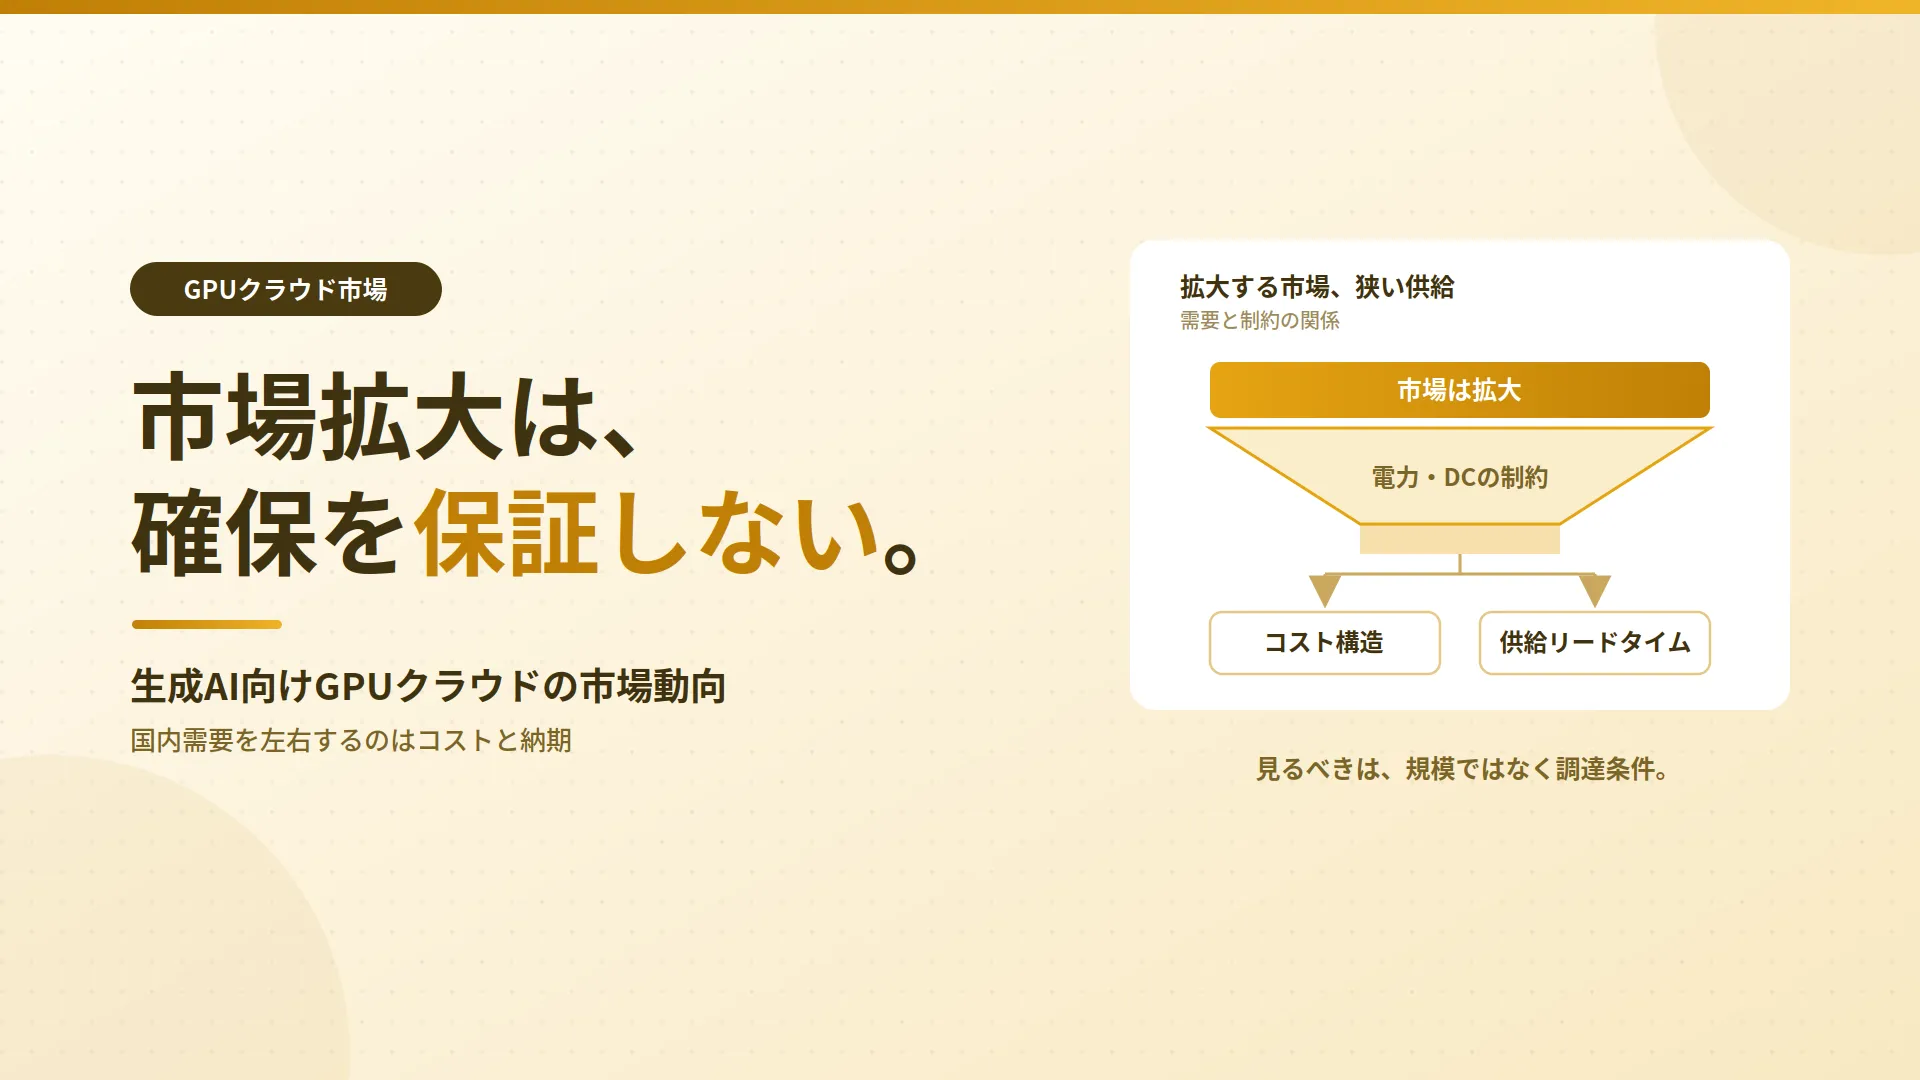
機密データを前提にした生成AIの活用を検討する場合、データを国内に置くという発想がなぜ求められるのか、その背景と国内の動向は関連記事の生成AIのデータを国内に置きたい|国産AIインフラが求められる理由で整理しています。国内で処理を完結させる受け皿となる国産GPUクラウドの市場動向と国内需要については、生成AI向けGPUクラウドの市場動向と国内需要もあわせて参照してください。利用ルールとあわせて、基盤側の選択肢も検討すると、守りたいデータの範囲に応じた判断がしやすくなります。
見落としやすい注意点
「学習に使われないから安全」と単純化するのは危険です。学習利用の有無は漏洩リスクの一部にすぎず、保存先や処理場所、アクセスできる範囲まで含めて確認する必要があります。また、利用規約やデータ取り扱いポリシーは改定され得るため、一度確認したら終わりにせず、定期的な見直しを前提にしてください。法令上の取り扱いは個別判断になるため、法務確認を前提にすることをおすすめします。
もう一つ見落としやすいのが、ルールと現場の実態が乖離するケースです。厳しすぎるルールは形骸化し、無断利用を招きます。実務で本当に使いたい用途を踏まえ、使える範囲を具体的に示すことが、結果としてリスクを下げることにつながります。
AIの利用ルールと基盤を一体で整理するなら
生成AIの社内利用ルールは、入力するデータの機密度、サービスごとのデータ取り扱い、そして処理が行われる場所を一体で捉えることで、納得感のある判断につながります。ルールだけを厳しくしても、基盤側で海外に処理が及んでいれば、意図せぬ越境移転は避けられません。
こうした論点を整理する具体的な手段として、イオレのAIインフラ事業では、扱うデータの要件整理から、国内で処理を完結させる構成の考え方、容量設計・運用設計・調達整理までの観点で検討を支援しています。一般的な判断軸を踏まえたうえで、守りたいデータの範囲に応じた基盤の考え方を整理する位置づけです。
※ 支援の範囲や前提条件は案件により異なります。詳細は問い合わせ導線からご確認ください。
まとめ
生成AIの業務利用が広がるほど、「何を入力してよいか」の線引きは避けて通れない論点になります。ルールがないまま利用が進むと、漏洩・学習利用・越境移転といったリスクが個人任せの判断のなかで蓄積していきます。
出発点は、サービス単位ではなくデータの機密度を軸に入力可否を決めることです。そのうえで、利用可能なサービスと範囲を明文化し、保存先・学習利用・ログ保持といった取り扱いを規約ベースで確認します。さらに、国内で処理が完結する基盤という選択肢まで視野に入れると、守りたいデータの範囲に応じた一貫した判断がしやすくなります。
- 入力可否はデータの機密度を軸に線引きする
- 保存先・学習利用・ログ保持はサービスの規約で時点を明記して確認する
- 国内で処理が完結する基盤なら越境移転そのものを避けやすい
- 法令上の取り扱いは個別判断のため法務確認を前提にする