生成AIの社内利用ルールの作り方|機密データの扱いと判断基準
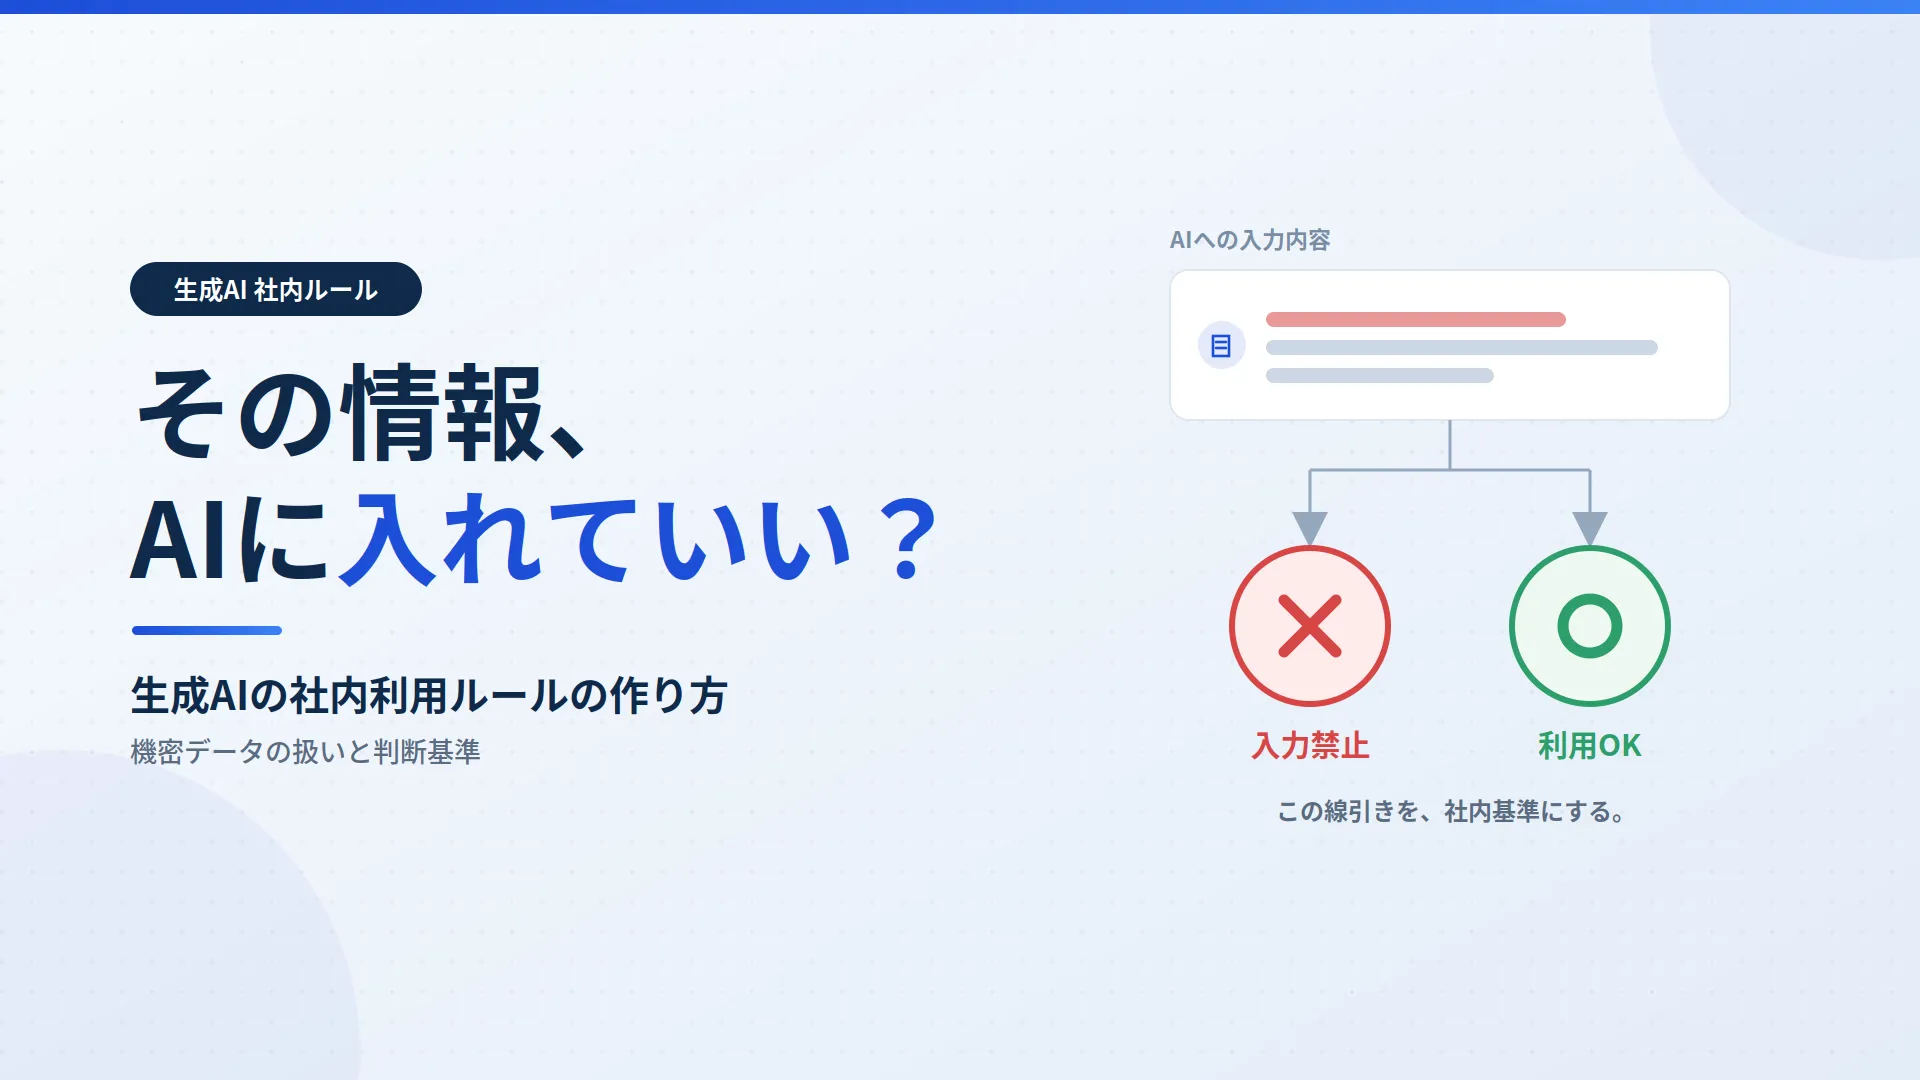
業務で生成AIを使う企業が増える一方、機密データや個人情報をどこまで入力してよいか社内の判断基準が追いつかないケースが少なくありません。データ分類の考え方、入力してよい/避けるべき情報の線引き、利用ルール整備の進め方を、一次情報をもとに実務目線で整理します。
- 生成AIへの入力データは漏洩・学習利用・越境移転のリスクを整理してから扱う
- 機密度でデータを分類し「入力してよい情報/避けるべき情報」を先に線引きする
AI Infrastructure Column
生成AIやAIインフラ市場の動向、業界構造、需要変化を整理するための仮カテゴリです。
業務で生成AIを使う企業が増える一方、機密データや個人情報をどこまで入力してよいか社内の判断基準が追いつかないケースが少なくありません。データ分類の考え方、入力してよい/避けるべき情報の線引き、利用ルール整備の進め方を、一次情報をもとに実務目線で整理します。
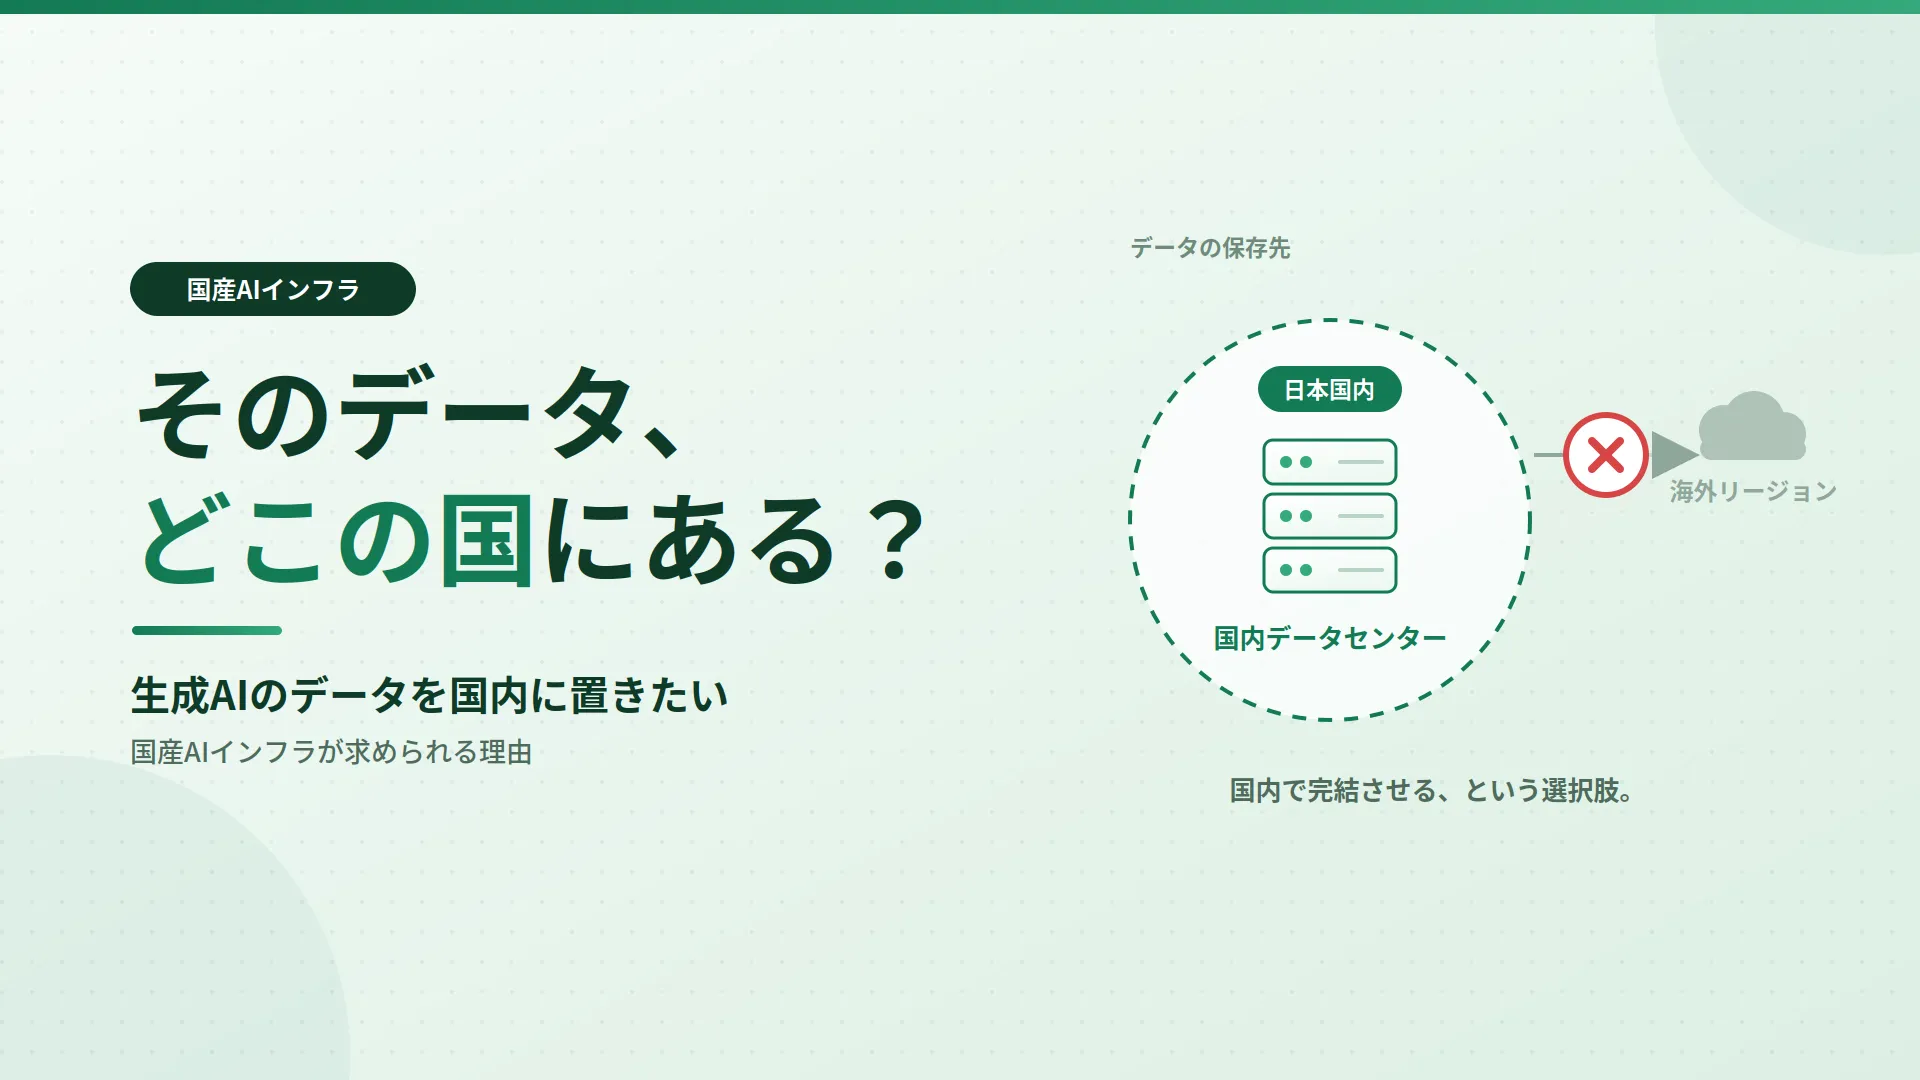
生成AIの業務利用が広がる一方で、機密データを海外クラウドに預けることへの懸念が高まっています。データを国内に置きたいニーズが生まれる背景、国産AIインフラが求められる理由、国内の整備・調達動向を、一次情報をもとに整理します。
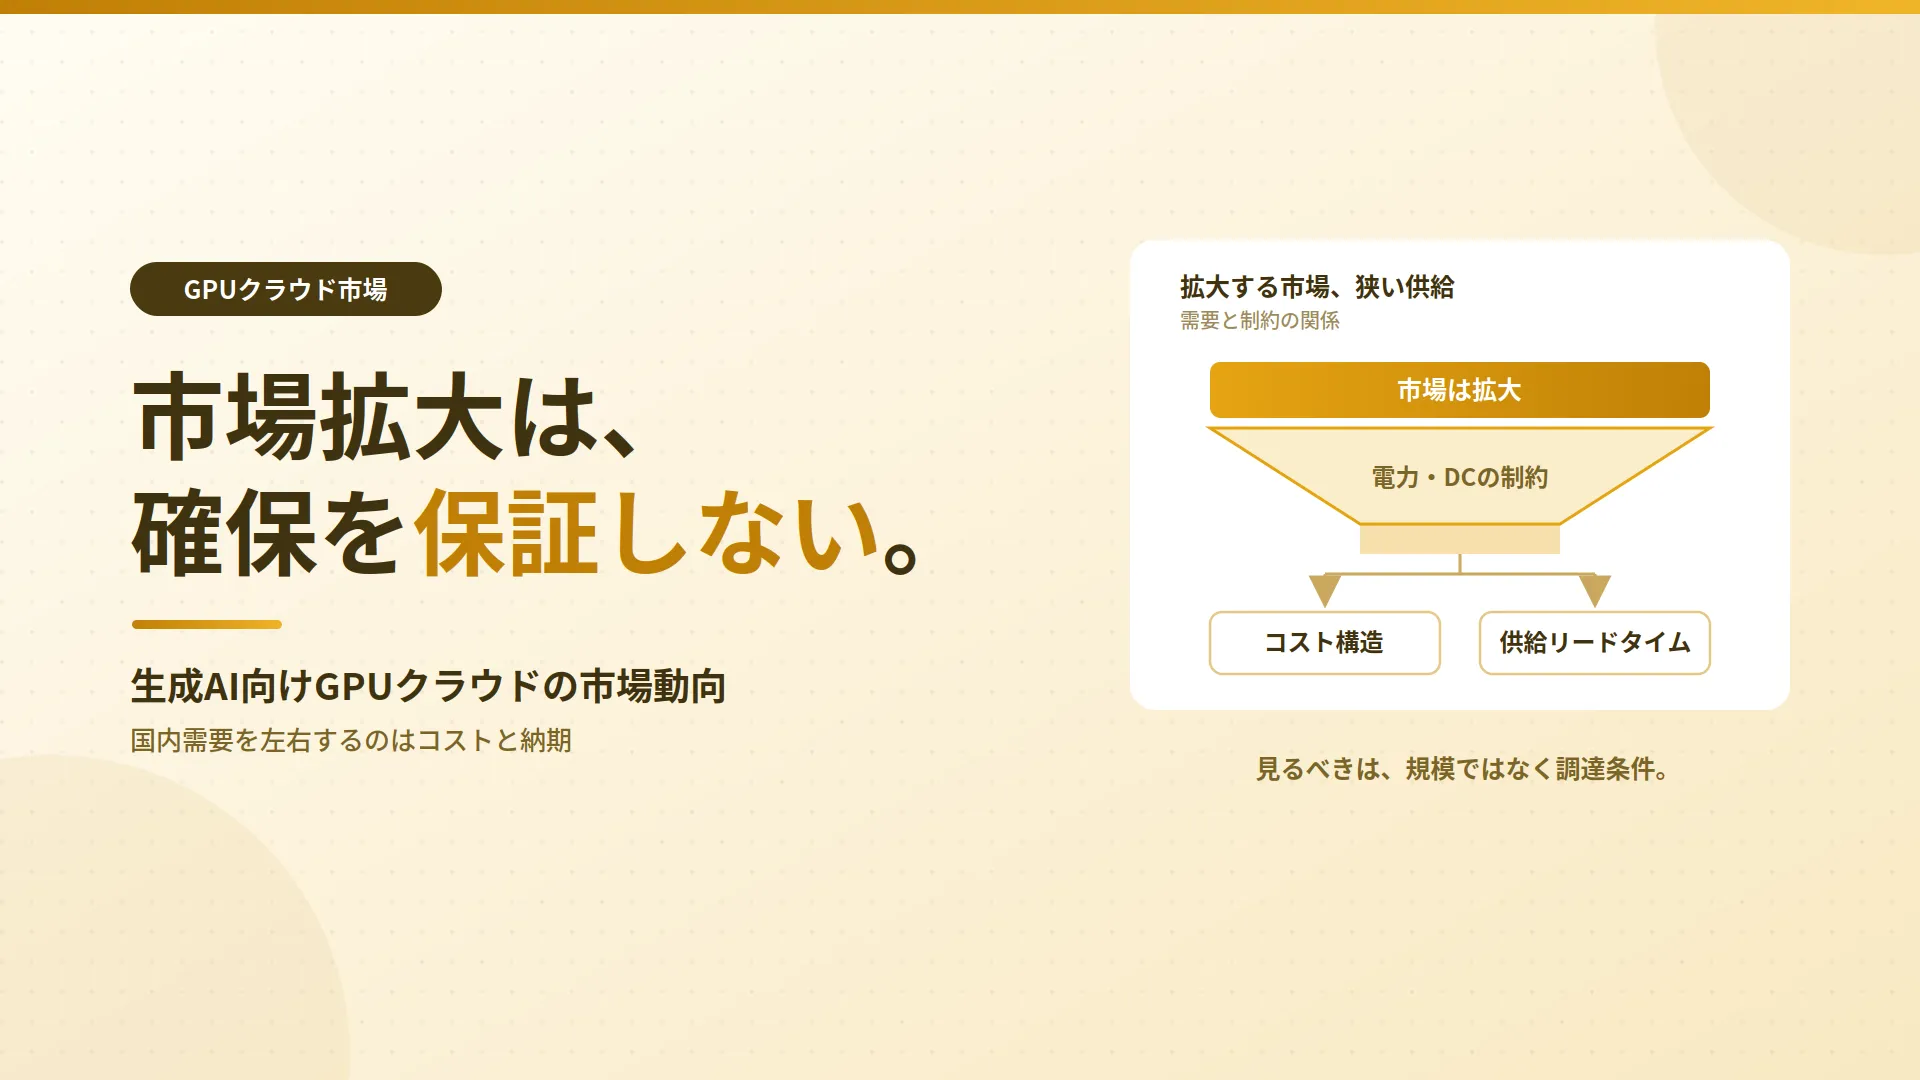
生成AIの普及でGPUクラウドの需要が急拡大しています。市場が伸びる背景、国内特有の需要要因、調達・選定で見るべき観点を、一次情報をもとに整理します。
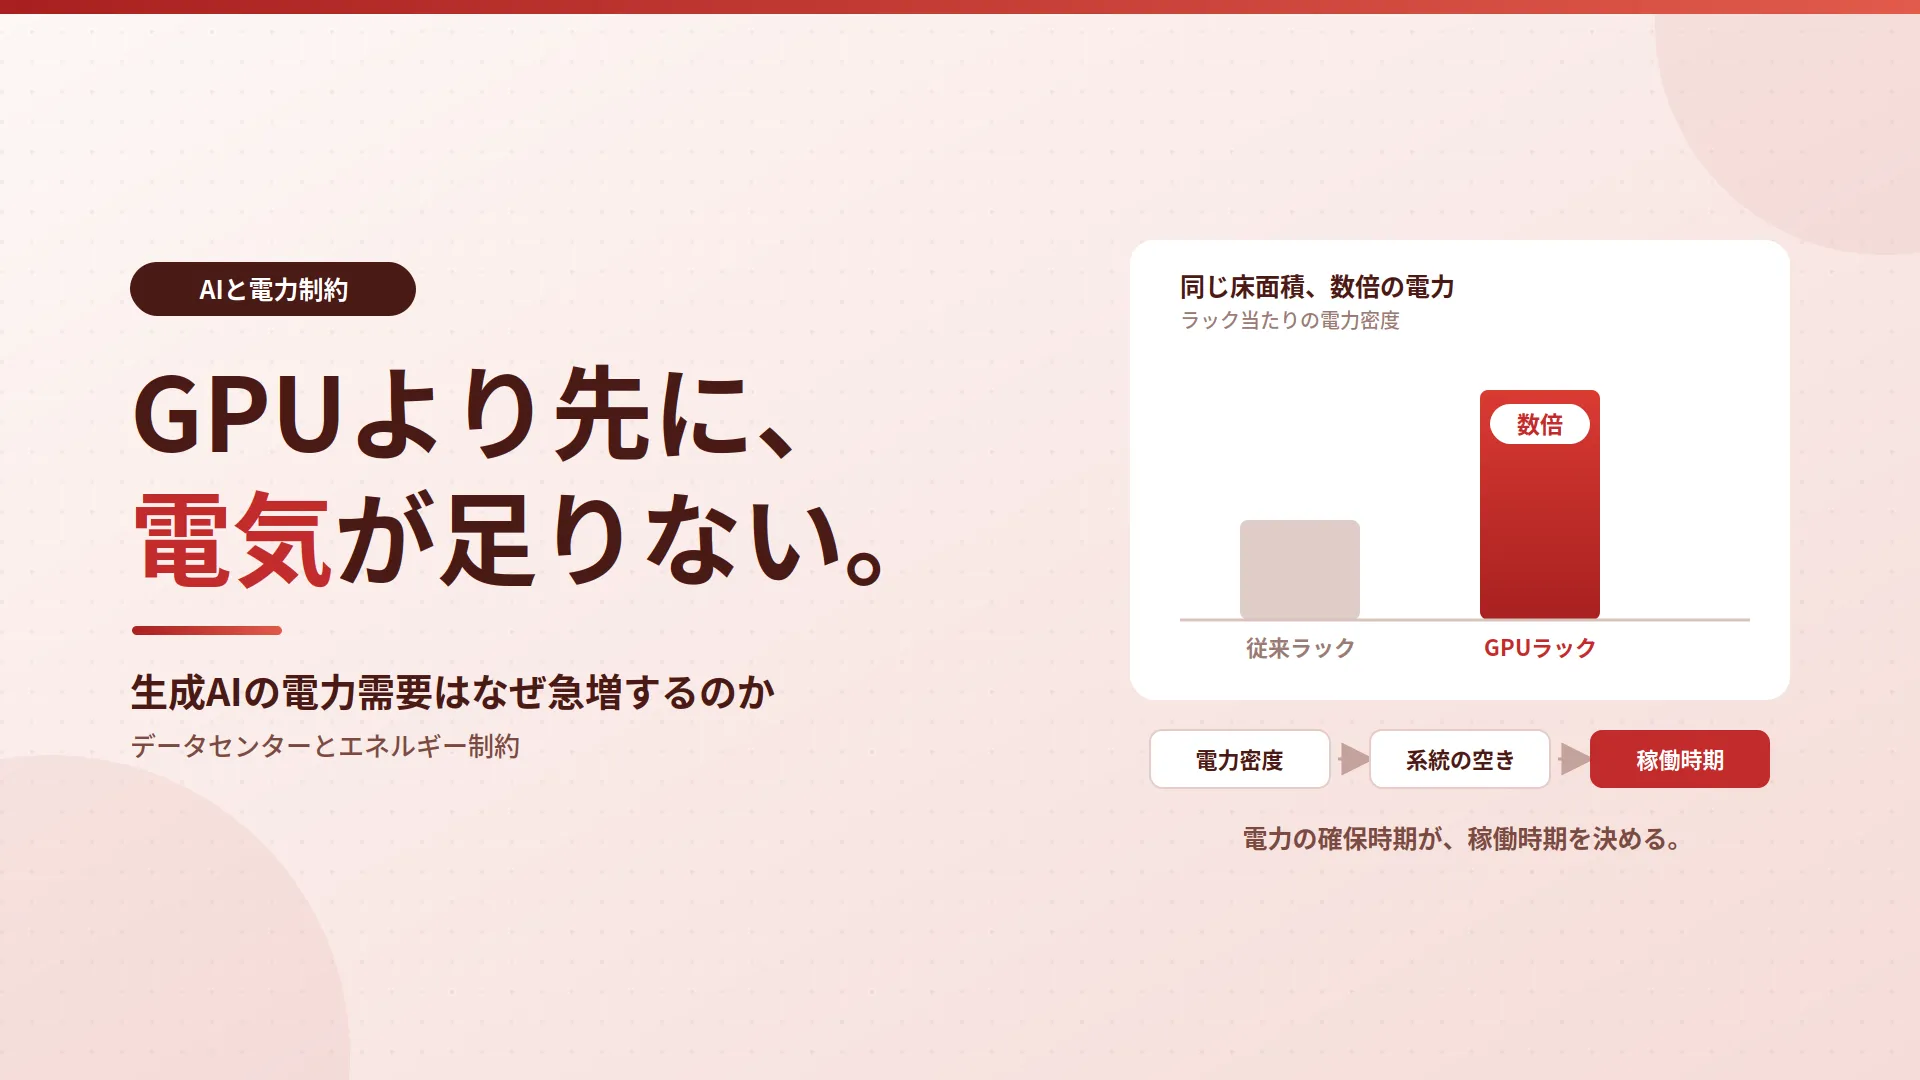
生成AIの普及でデータセンターの電力需要が急増しています。需要が伸びる理由、電力・エネルギー面の制約、AIインフラの立地・調達判断に与える影響を、一次情報をもとに整理します。