30秒で要約
- AIの本体は「モデル」と呼ばれ、その中身は学習でできあがった大量の数値。装置ではなくデータなので、実体はファイルとして存在する
- ファイルである以上、大きさがある。それを表しているのが、モデル名の末尾に付く「8B」「70B」といった数字
- Bは10億を指す。70Bなら、内部に700億個の数値を持つという意味になる
- 数値が増えると扱える内容の幅は広がるが、計算量と、数値を置いておくメモリの量も同時に増える
- モデルがGPUのメモリに載り切るかどうかが必要な枚数を決める。ただし必要量は量子化や入力の長さで変わる
AIの話題では「モデル」という言葉が当たり前のように登場します。モデルを動かすにはGPUが要る、大きなモデルはコストがかかる、といった説明も見かけます。ところが、そのモデルが何なのかは説明されないまま先に進むことが少なくありません。機械なのか、プログラムなのか、それとも別の何かなのか。
この記事は、AIの中身に何が入っているのかという地点から出発します。中身が分かると、ニュースで見かける「70B」という数字の意味も、なぜGPUの枚数の話になるのかも、一本の線の上でつながります。
- AIの本体は数値のかたまりであり、実体はデータとして存在する
- モデル名の「70B」は、その数値が700億個あるという意味
- 大きさはできることと必要な装置の両方を同時に決める
- 大きいほど良いとは限らず、用途に対して過剰になることがある
そもそもAIは何でできているのか
AIの「本体」はどこにあるのか
最初に押さえておきたいのは、AIが特別な機械ではないという点です。
AIを使うとき、画面の向こうで動いているのはサーバーです。ただし、そのサーバー自体がAIなのではありません。サーバーは計算をするための装置であって、同じ装置に別のデータを読み込ませれば、別の振る舞いをします。AIらしさを決めているのは、装置ではなく、その上に読み込まれているデータのほうです。
このデータを モデル 用語解説 AIの中身にあたるデータ。学習によって調整された大量の数値が保存されており、これを計算に使うことで入力に対する答えが決まる。 と呼びます。以降はこの言葉を使います。AIのニュースで「新しいモデルが公開された」と言われているとき、公開されているのは装置ではなく、このデータです。
中身は、学習でできあがった数値のかたまり
ではモデルの中身を開けると何が入っているのか。文章でも画像でもなく、ひたすら数値が並んでいます。
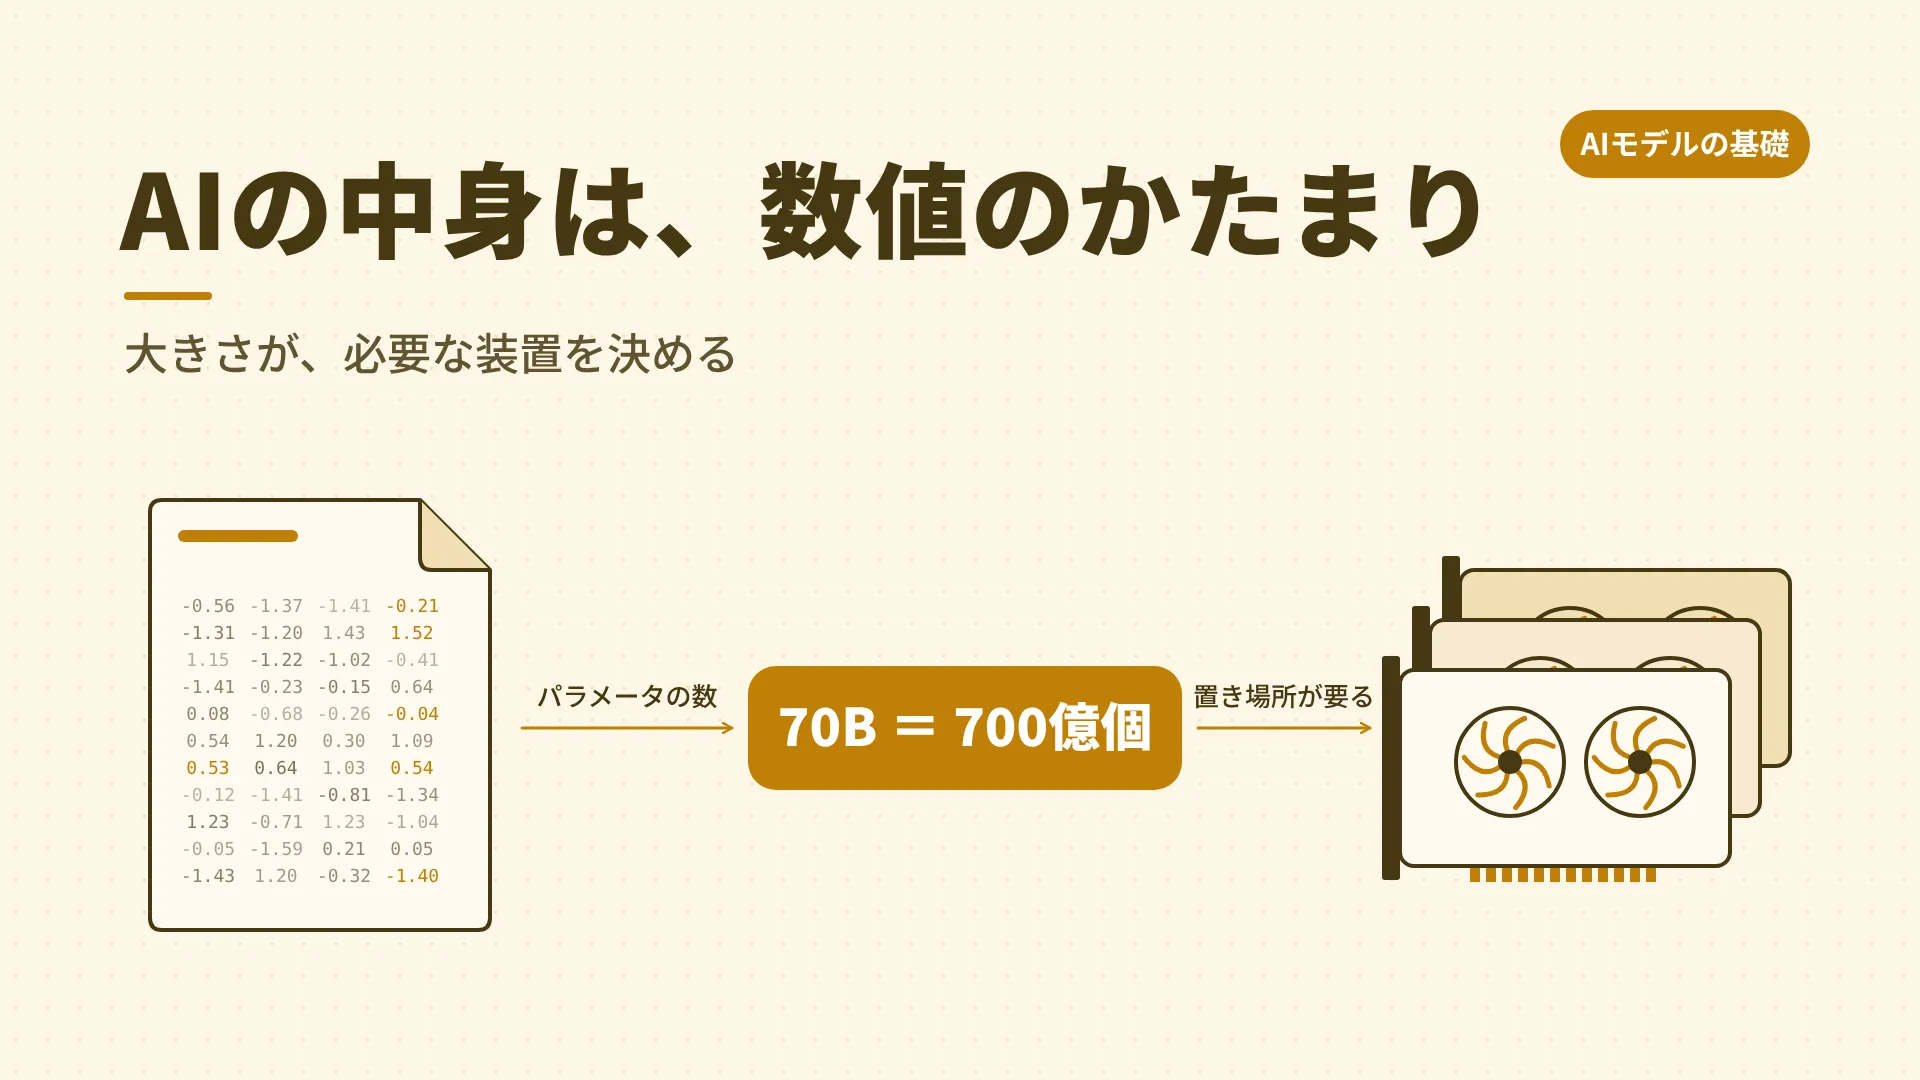
この数値の一つひとつを パラメータ 用語解説 モデルが持つ数値。重みとも呼ばれ、この値の組み合わせがモデルの振る舞いを決める。 と呼びます。パラメータという言葉は設定項目を指して使われることもありますが、AIの文脈では人が設定する値ではありません。学習の過程で機械が自動的に決めていった数値を指します。
AIが文章を作るときにやっているのは、入力された文章を数値の並びに変換し、その数値とパラメータを掛け合わせ、結果を足し合わせていく作業です。これを何段も重ねた先に出てきた数値を、人間が読める言葉に戻したものが回答として表示されます。難しい計算をしているのではなく、単純な計算を大量にしているという点については、なぜAIにGPUが必要なのか|CPUとの違いから分かる仕組みで詳しく整理しています。
実体はファイル ─ だから「大きさ」がある
ここが、この記事の後半につながる分かれ目です。
モデルが数値の集まりである以上、それはファイルとして保存できます。写真や音楽や動画のファイルと同じように、保存すれば容量を取る。配布するときはダウンロードする。別のサーバーで使いたければコピーして持っていく。AIというと実体のないものを想像しがちですが、扱い方としてはファイルに近いものです。
そしてファイルである以上、大きさがあります。この「大きさ」が、できることと、動かすのに必要な装置の両方を左右していきます。
※ 大きなモデルは1つのファイルではなく、複数のファイルに分割して配布されることが多くあります。ここで言う「ファイル」は、装置ではなくデータとして存在するという意味で使っています。
- AIの本体は装置ではなく、読み込まれるデータのほうにある
- そのデータをモデルと呼び、中身は大量の数値
- データである以上ファイルとして保存でき、大きさを持つ
その数値は、どうやってできるのか
数値を調整していく作業が「学習」
モデルの中の数値は、最初から正しい値が入っているわけではありません。出発点ではでたらめな値が並んでいます。
そこに大量のデータを読み込ませ、出てきた答えと正解とのずれを測り、ずれが小さくなる方向へ数値を少しずつ動かす。これを膨大な回数繰り返した結果、望ましい答えが出る数値の組み合わせにたどり着きます。この工程が 学習 用語解説 大量のデータを読み込ませ、モデル内部の数値を調整していく工程。トレーニングとも呼ばれる。 です。
言い換えると、学習とは数値を作る作業にほかなりません。学習が終わった時点で、モデルというファイルが1つできあがります。
できあがったものを使うのが「推論」
いっぽう、できあがったモデルに質問を投げて答えを受け取る工程を 推論 用語解説 学習を終えたモデルに入力を与え、答えを出させる工程。インファレンスとも呼ばれ、利用者が実際にAIを使うときに動くのはこちら。 と呼びます。
重要なのは、推論では数値が変化しないという点。モデルの中の値は固定されたまま、入力を通して答えを出すだけです。利用者が業務でAIを使っているとき、動いているのはこちらになります。
この2つの工程は必要な設備も費用の出方も異なります。詳しくはAIの「学習」と「推論」はどう違うのか|必要な設備とコストの差で整理しています。
モデルを使うたびに、中身の数値は賢くなっていくのですか?
いいえ、推論では数値は変わりません。 数値が変わるのは学習のときだけです。
ニュースで見る「70B」は何の数字なのか
モデル名の末尾にある英数字
公開されているモデルの名前には、末尾に英数字が付いていることがあります。
たとえばMetaが公開したLlama 3.1には、8B、70B、405Bという3つの大きさが用意されています。名前の本体は同じで、末尾の数字だけが違う。この数字が、そのモデルの大きさを表しています。
出典: Meta「Introducing Llama 3.1: Our most capable models to date」。Llama 3.1として8B、70B、405Bの3つのサイズが公開されています。2026年10月時点。
Bは10億 ─ 8Bは80億、70Bは700億
末尾のBは、英語のbillion、つまり10億を指す表記です。桁が大きくなりすぎるため、省略する慣例として使われています。
| 表記 | パラメータの数 |
|---|---|
| 8B | 80億個 |
| 70B | 700億個 |
| 405B | 4,050億個 |
数値を1個ずつ数えた数
この数字が何を数えたものなのかが、いちばん誤解されやすいところです。ファイルの容量でも、読み込ませたデータの量でもありません。モデルの中に入っている数値そのものの個数です。
70Bであれば、1つのモデルの中に700億個の数値が並んでいる。そして質問を1回投げるたびに、その数値が計算に関わります。AIを動かすのに大がかりな装置が要ると言われる理由は、突き詰めるとこの個数に行き着きます。
- モデル名の末尾の数字はパラメータの個数を表す
- Bは10億。70Bなら700億個の数値を持つ
- ファイル容量でも学習データ量でもなく、数値そのものの個数
数が増えると、何が変わるのか
できることの幅と、答えの確からしさ
数値の個数が多いほど、モデルは複雑な関係を表現できます。扱える話題の幅が広がり、込み入った指示にも対応しやすくなる。小さなモデルでは崩れてしまう長い文章の筋道を、大きなモデルは保ちやすい傾向があります。
ただし、増やせば必ず良くなるという単純な関係ではありません。この点は後述します。
同時に増えるもの ─ 計算量と、置いておく場所
見落とされがちなのは、増えるのが良い面だけではないという点です。
1回の受け答えで関わる数値が増えるため、計算の回数が増えます。計算が増えれば、答えが返るまでの時間も、消費する電力も増える。さらに、計算のあいだはその数値をすぐ取り出せる場所に置いておく必要があり、置き場所も余分に要ります。
つまりモデルを大きくすることは、性能と引き換えに、時間・電力・設備を差し出す選択になります。
大きいほど良い、とは限らない
同じパラメータ数でも、どんなデータをどう学習させたかで結果は変わります。新しい手法で作られた小さなモデルが、古い大きなモデルを上回ることもあります。パラメータ数は大きさの指標であって、性能の指標ではありません。
用途との釣り合いも重要です。決まった形式の文書を分類する、定型の問い合わせに答えるといった範囲なら、小さなモデルで足りることが多くあります。そこに大きなモデルを持ち込むと、応答が遅くなり、設備の費用だけがかさむ。用途に対して過剰な大きさは、不利にしかなりません。
- 数値が増えると扱える幅は広がる
- 同時に計算量と置き場所も増える
- パラメータ数は大きさの指標であって性能の指標ではない
大きさは、必要な装置をどう決めるのか
数値の個数と、必要なメモリの量
ここからが、AIの話とインフラの話がつながる部分です。
計算のあいだ、モデルの数値はすぐ取り出せる場所に置かれている必要があります。数値1個を保存するのに必要な容量は、よく使われる形式でおおよそ2バイト。個数を掛ければ、必要なおおよその容量が出ます。
| モデルの表記 | パラメータの数 | 必要なメモリの目安 |
|---|---|---|
| 8B | 80億個 | 約16GB |
| 70B | 700億個 | 約140GB |
| 405B | 4,050億個 | 約810GB |
数値1個あたり2バイトとして計算した概算です。実際には後述する条件で増減します。
1枚のGPUに載らなくなると何が起きるか
この置き場所にあたるのが、GPUに搭載された VRAM 用語解説 GPUに搭載された専用メモリ。計算対象のデータやモデルのパラメータを保持する領域。 です。そして、VRAMの容量はGPU1枚ごとに決まっています。
たとえばNVIDIAのH100は、SXM形状で80GB、NVL形状で94GBと公表されています。先ほどの表と見比べると、何が起きるかが見えてきます。8Bの約16GBなら1枚に収まる。ところが70Bの約140GBは、1枚にはどうやっても載りません。
出典: NVIDIA「NVIDIA H100 Tensor Core GPU」製品ページの仕様。2026年10月時点。
載らなければ、GPUを複数枚使ってモデルを分割して持つことになります。それでも足りなければ、サーバーを何台も並べる。AIの話題でデータセンターや電力が登場するのは、この先の段階です。置き場所の条件そのものはAI向けデータセンターとは何か|普通のサーバー室と何が違うのかで整理しています。
目安が成り立つ条件と、崩れる条件
実際に必要な容量は、これより多くなるのが通常です。モデルの数値を置く分に加えて、計算の途中経過を保持する領域や、処理のための作業領域が別に要るためです。逆に、次に説明する方法で必要量を減らすこともできます。「このGPU1枚で何Bまで動く」と一律に言い切れる数字は存在しません。
- 数値の個数に応じて必要なメモリの量が決まる
- 置き場所はGPUのVRAMで、容量は1枚ごとに決まっている
- 載り切らなければ複数枚、複数台の話になる
同じモデルでも、必要な容量は変わる
量子化 ─ 数値の表現を粗くして小さくする
同じモデルでも、必要な容量を減らす方法があります。 量子化 用語解説 モデル内部の数値をより少ないビット数で表現し、必要なメモリ量と計算量を減らす手法。出力品質に影響する場合がある。 です。
考え方は、小数点以下の桁数を減らすことに似ています。3.14159を3.14で済ませれば、保存に必要な容量は小さくなる。モデルでも同じように数値の表現を粗くすれば、1個あたりのバイト数が減り、全体の容量も下がります。
ただし、粗くすれば答えの質に影響が出る可能性があります。どこまで粗くしてよいかは用途によって変わるため、適用するなら出力の品質を個別に確かめることが前提です。選定時の優先順位の付け方はAI推論向けGPUの選び方|初めてでも迷わない5つの観点で扱っています。
文章が長くなるほど余分に要る
もう1つ、見落とされやすい要素があります。入力する文章の長さです。
AIが一度に扱える文章の量には上限があり、これを コンテキスト長 用語解説 モデルが一度に扱える入力と出力の量の上限。トークンという単位で表される。 と呼びます。単位には トークン 用語解説 AIが文章を処理するときの区切りの単位。単語よりやや細かく分割されることが多い。 が使われます。たとえばLlama 3.1は、8B・70B・405Bのいずれも128Kトークンに対応すると公表されています。
長い文章を扱うと、その内容を保持するための領域が別途必要になります。同じモデルでも、短い質問を1つ投げる場合と、長い資料を読ませる場合とでは、必要なメモリの量が変わるということです。しかも複数の利用者が同時に使えば、その分だけ積み上がります。
出典: Meta「Introducing Llama 3.1」およびLlama 3.1モデルカード。2026年10月時点。
- 量子化で必要な容量を下げられるが、品質への影響を確認する前提
- 入力が長いほど余分なメモリが要る
- 同じモデル名でも、条件によって必要量は変わる
よくある疑問
手元のパソコンで動かせるのはどのくらいまでか
分かれ目になるのは、やはりメモリの容量です。小さなモデルであれば、一般的なパソコンでも動きます。量子化された軽量版が公開されているモデルも多く、学習目的で試すなら小さなものから触るのが現実的な入口になります。
容量を超えると、動かないか、動いても極端に遅くなります。速さの問題というより、置き場所が足りているかどうかの問題だと捉えると分かりやすくなります。
パラメータ数が同じなら、性能も同じなのか
同じにはなりません。中身の数値は学習でできあがるものなので、何をどう学習させたかによって結果が変わります。
パラメータ数が分かることで見当が付くのは、必要な装置の規模のほうです。性能の見当を付けたい場合は、自分の用途に近い課題で実際に試して比べる必要があります。
大きいモデルと小さいモデル、どちらから始めるべきか
用途がはっきりしているなら、小さいほうから試すと判断材料が得られやすくなります。小さなモデルで足りれば装置も費用も抑えられる。足りなければ、どこが足りなかったのかが具体的に分かります。
逆に大きいモデルから入ると、それで動いたときに「本当にその大きさが要ったのか」を確かめる手がかりが残りません。
自社に合う規模を見極めるなら
業務でAIを動かす段になると、ここまでの観点を自社の条件に当てはめる作業が必要になります。何をさせたいのかという用途から必要なモデルの規模を見当づけ、そこから必要なGPUの構成を決め、置き場所の条件を確かめる。この順番で進めると、後戻りが少なくなります。
こうした検討の具体的な手段として、イオレのAIインフラ事業ではGPUサーバーの販売を担っています。データセンター環境への設置と、稼働後の保守・運用は、それぞれを専門とするパートナー企業と連携して提供する体制です。扱いたいモデルの規模と、設置先の条件を切り離さずに相談できる窓口という位置づけになります。
※ 設置・保守・運用はパートナー企業による提供です。支援の範囲や前提条件は案件により異なります。詳細は問い合わせ導線からご確認ください。
まとめ
AIが何でできているのかという問いは、「学習でできあがった大量の数値」という一点に行き着きます。AIは特別な機械ではなく、本体にあたるのはサーバーに読み込まれるデータのほう。そのデータをモデルと呼び、実体はファイルとして存在します。
ファイルである以上、大きさがあります。モデル名に付く「8B」「70B」という表記は、その中に数値が何個入っているかを表したもの。Bは10億を指すので、70Bなら700億個です。
そして、この個数が必要な装置を決めていきます。数値を置いておく場所がGPUのVRAMであり、載り切らなければ複数枚、複数台という話になる。AIの話題でデータセンターや電力が出てくるのは、この延長線上にあります。
ただし、大きければ良いという関係ではありません。パラメータ数は大きさの指標であって性能の指標ではなく、用途に対して過剰な大きさは応答時間と費用だけを押し上げます。必要な容量も、量子化や入力の長さで変わる。モデル名だけで必要な装置が確定するわけではない、という前提で読み進めることが大切です。
装置の側をもう少し知りたい場合はなぜAIにGPUが必要なのか|CPUとの違いから分かる仕組みへ、AIを動かす工程そのものを知りたい場合はAIの「学習」と「推論」はどう違うのか|必要な設備とコストの差へ進んでみてください。
- AIの本体は学習でできた数値のかたまり
- モデル名の「70B」は700億個という意味
- 数値の個数が必要なメモリと装置の規模を決める
- パラメータ数は性能の指標ではなく、用途との釣り合いで選ぶ