3秒でわかるこの記事の要点
- AIを動かす作業は「学習」と「推論」という性質の違う2つに分かれる
- 必要な設備の規模も費用の出方も、両者で大きく変わる
- 多くの場合まず必要になるのは推論であり、そこから見積もりを始める
「AIを業務に使いたい」という話が出たとき、次に問われるのは「では何が必要になるのか」です。ここで見積もりが立たなくなる原因のひとつは、「AIを動かす」という一言のなかに、性質のまったく異なる2つの作業が混ざっていることにあります。その2つが「学習」と「推論」です。この記事では、それぞれが何をしている工程なのか、必要な設備と費用がどう変わるのかを、専門用語をひとつずつ補いながら整理します。どちらの段階の話をしているのかを切り分ける見方を持ち帰っていただくことが目的です。
- 「学習」と「推論」がそれぞれ何をしている工程なのか
- 必要な設備と費用の出方がどう変わるのか
- 自社が必要としているのはどちらなのか
AIを動かすには2つの段階がある
この2つの関係は、人が仕事を覚えて実際にこなすまでの流れに置き換えると掴みやすくなります。
学習 用語解説 大量のデータを読み込ませ、AIモデルにパターンを身につけさせる工程。トレーニングとも呼ばれる。 は、教科書や過去の事例を読み込んで判断の勘所を身につけていく段階。時間はかかりますが、期間を区切って取り組む作業です。これに対して 推論 用語解説 学習を終えたAIモデルに入力を与え、答えを出させる工程。インファレンスとも呼ばれ、利用者が実際にAIを使うときに動くのはこちら。 は、身につけた内容を使って目の前の問いに答える段階。窓口に立って相談に回答していく作業にあたります。
この2段階という捉え方は、この記事だけの整理ではありません。総務省「令和元年版 情報通信白書」でも、機械学習には基本的に「学習」と「推論」の2つのプロセスがあり、それぞれのプロセスで異なるデータを使うことになると整理されています。
押さえておきたいのは、この2つが同時に進むわけではないという点。学習を終えたモデルが、その後は推論だけを繰り返します。そして業務でAIが使われているとき、動いているのは推論のほうです。
AIを動かす環境を用意したいのですが、GPUは何台くらい必要ですか?
自社で学習させるのか、できているモデルを使うだけなのかで前提が変わります。 どちらを想定していますか?
「学習」と「推論」は何が違うのか
学習 ─ データを読み込んでパターンを覚える
学習で行われているのは、 モデル 用語解説 AIの本体にあたるもの。入力に対してどう出力するかのルールが、膨大な数の数値として保持されている。 の中身を少しずつ望ましい方向へ調整していく作業です。データを読み込ませ、出てきた答えと正解のずれを測り、ずれが小さくなるように調整する。これを膨大な回数繰り返すため、多数のGPUを長時間動かす必要が生じます。
一方で、学習には終わりがあります。目標とする精度に届けば、その回の学習は完了。ここが推論との決定的な違いです。
なお「学習」と聞くと、ゼロからAIを作るイメージを持たれがちですが、実際には規模のまるで違う選択肢が含まれています。
学習をめぐる3つの選択肢
ゼロから学習させる
大量のデータを用意し、モデルを一から作る。必要な計算資源とデータ量の規模が非常に大きい。
既存モデルに追加で学習させる
公開されているモデルを土台に、自社のデータで調整する。ゼロから作る場合と比べれば規模は小さくなる。
学習させず、そのまま使う
既存モデルに手を加えずに推論だけを行う。多くの業務利用はここから始まる。
2番目にあたるのが ファインチューニング 用語解説 学習済みのモデルに追加のデータを学習させ、特定の用途や表現に合わせて調整する手法。追加学習とも呼ばれる。 です。1番目を一般企業が自社で行う場面は限られます。検討の入口では、2番目と3番目のどちらかを想定しておけば足りると言えます。
推論 ─ 覚えた内容で答えを出す
推論は、学習を終えたモデルに入力を渡し、出力を受け取る処理です。利用者が質問を投げ、回答が返ってくる。その1往復が推論の1回分にあたります。処理される量は トークン 用語解説 AIが文章を処理するときの区切りの単位。単語よりやや細かく分割されることが多く、入力と出力の量はこの数で数えられる。 という単位で数えられ、入力と出力が長いほど1回あたりの計算量は増えます。
推論の性質を一言で言えば、使われ続ける限り終わらないことです。社内10人の試験導入と全社1,000人への展開では、1人あたりの利用回数が同じでも発生する推論の回数は二桁変わります。学習が「一度やれば終わる作業」だったのに対し、推論は利用量に応じて必要な処理能力がそのまま増えていく。ここを見落とすと、試験導入時の実績をもとにした見積もりが本番で合わなくなります。
もうひとつ、推論には学習になかった制約があります。待ち時間です。学習は数日かかっても構いませんが、推論の応答が数十秒かかると業務では使えません。応答速度が利用者の体験に直結する点も、学習との大きな違いです。
- 学習は終わりがある作業、推論は使われる限り終わらない
- 多くの業務利用は「学習させず、そのまま使う」から始まる
- 推論では応答速度が業務での使いやすさを直接左右する
必要な設備と費用がどう変わるのか
ここまでの違いが、そのまま設備と費用の違いになって現れます。
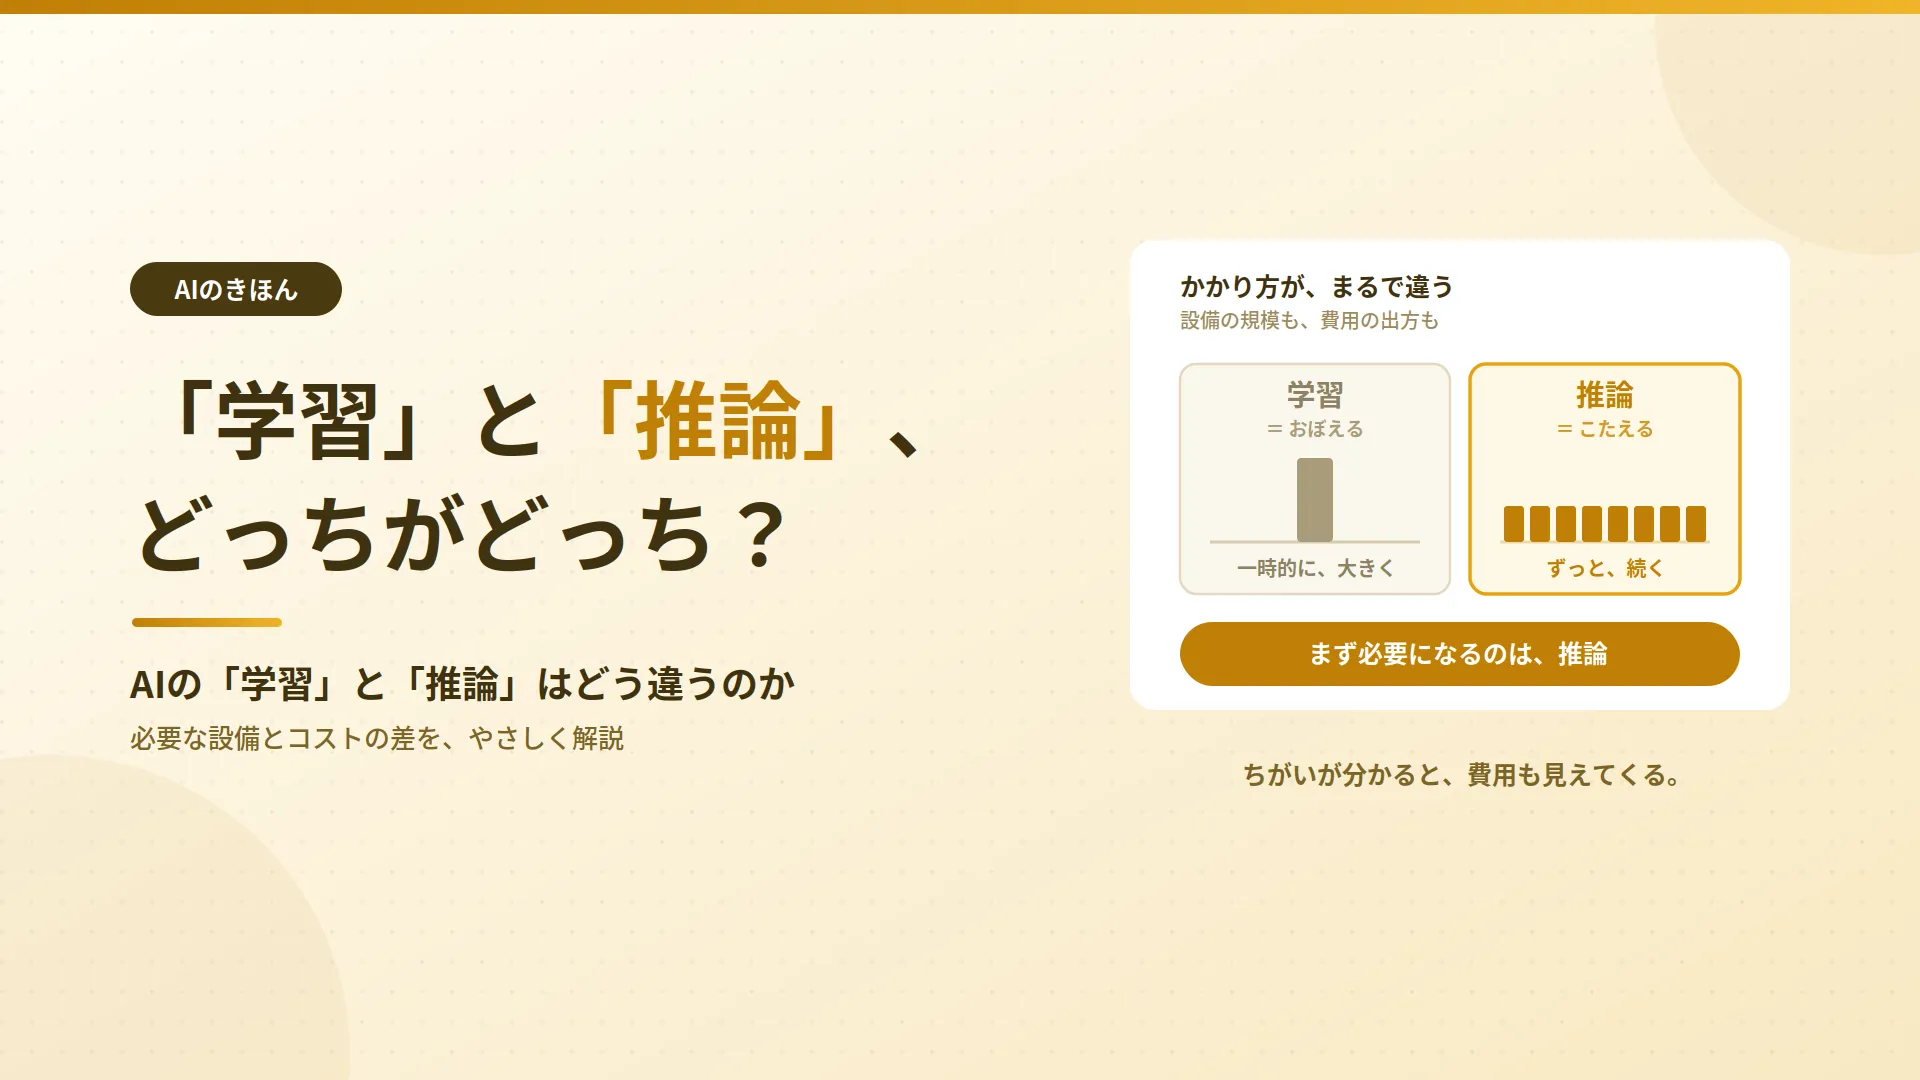
学習は、期間を区切って多数のGPUを集中的に動かすプロジェクト型の使い方です。費用も一時的に大きく発生します。対する推論は、少ない台数を止めずに動かし続ける常時稼働型。業務時間中はもちろん、社内システムに組み込むなら夜間も動かすことになり、費用は毎月発生し続けます。社内の手続きに引き直せば、前者は設備投資に近く、後者は運用費に近い。稟議の立て方も予算の置き場所も変わります。
| 対象 | 稼働のしかた | 費用の出方 |
|---|---|---|
| 学習 | 期間を区切って集中的に動かす | 一時的に大きく発生する |
| 推論 | 使われる限り動かし続ける | 継続的に発生し、利用量で伸びる |
一般的な傾向の整理です。扱うモデルの規模や用途によって、必要な構成は変わります。
この違いを意識せずに「AI導入の費用」として一本にまとめると、初年度の見積もりは通っても2年目以降に説明できなくなります。試算するときは、モデルや構成を検討する前に、想定利用者数と1人あたりの利用回数を先に置いてください。この2つが決まらないと、必要な処理能力も費用も定まりません。
もう一歩踏み込むときの参考記事
- 推論用GPUの選び方 → AI推論向けGPUの選び方|初めてでも迷わない5つの観点
- 電力の使われ方 → 生成AIの電力需要はなぜ急増するのか|データセンターとエネルギー制約
- 機器を置く場所の条件 → AI向けデータセンターとは何か|普通のサーバー室と何が違うのか
- 買うか借りるかの判断 → 生成AI向けGPUクラウドの市場動向と国内需要
まず必要になるのはどちらか
検討の入口にいる段階で必要になるのは、たいてい推論です。公開されているモデルを使って社内の問い合わせ対応や文書作成を支援する、といった用途では、モデルに手を加える必要がありません。使うだけなら推論だけで完結します。
追加学習を検討する余地があるのは、自社固有の用語や様式に沿った出力が必要なときなど、「既存モデルのままでは届かない」という具体的な不足が見えている場合です。
追加学習を検討する前に、指示の書き方を工夫する方法や、社内文書を参照させて回答させる方法で足りないかを確認してください。これらで解決できる場合、学習のための設備と手間を省けます。
社内で議論を進める前に、次の項目を埋めておくと話が具体化します。
- 実現したいことは既存モデルの利用で足りるか
- 学習や追加学習が必要な理由を言語化できているか
- 推論の想定利用者数と1人あたりの利用回数を出したか
- 応答速度の要件を決めたか
- 費用を一時費用と継続費用に分けて試算したか
- 入力するデータの機密度を整理したか
よくある誤解
最後に、この区別をめぐって起きやすい行き違いを整理します。
- 分けずに見積もると規模が合わない: 「AI用のGPU環境」という粒度で話が進んでいる場合、設備が過大にも過小にもなります。どちらの話なのかを先に確認してください。
- 学習が終われば完了ではない: 使われ続ける限り推論の費用は発生し、利用が広がれば増えていきます。
- 推論は軽い処理とは限らない: 扱うモデルの規模が大きい場合や、同時に多数の利用が集まる場合は、推論でも相応の設備が必要になります。
もうひとつ、初めての検討でとくに混同されやすい論点があります。
生成AIに社内のデータを入力することは、それ自体が「学習」ではありません。入力したデータがモデルの学習に使われるかどうかは、利用するサービスの規約と設定で決まる別の論点です。「学習させていないから安全」という説明も、「入力したから学習される」という懸念も、どちらも前提の確認なしには成り立ちません。規約と設定を個別に確認してください。
入力データの扱いは、社内ルールを整えるうえで避けて通れない論点になります。整理の進め方は生成AIの社内利用ルールの作り方|機密データの扱いと判断基準にまとめています。
AI基盤の構成を検討するなら
AI基盤の検討は、機器の選定から入ると判断材料が足りなくなりがちです。学習と推論のどちらを担わせるのかを先に切り分け、そこから必要な性能、稼働パターン、置き場所の条件を順に決めていく。この順序で進めると、後戻りの少ない検討になります。
こうした整理を進める具体的な手段として、イオレのAIインフラ事業では、GPUサーバーの販売から、要件に合うデータセンター環境への設置、専門企業による保守・運用までをワンストップで支援しています。
※ 支援の範囲や前提条件は案件により異なります。詳細は問い合わせ導線からご確認ください。
まとめ
AIを動かす作業は、パターンを覚える「学習」と、覚えた内容で答えを出す「推論」に分かれます。学習は期間を区切って集中的に動かす短期型、推論は止めずに動かし続ける常時稼働型。費用も、前者は一時的な支出、後者は利用量に比例して伸びる継続的な支出になります。
そして検討の入口で必要になるのは、多くの場合推論です。まず既存モデルの利用で目的を達せられないかを確認し、そこから想定利用者数と応答速度の要件を置く。この順序で進めることが、現実的な見積もりへの近道だと言えます。
- 学習と推論は別の作業であり、必要な設備が違う
- 学習は一時費用、推論は利用量に比例する継続費用
- まず自社が必要としているのはどちらかを切り分ける