3秒でわかるこの記事の要点
- 推論用GPUは、学習用とは選ぶ基準が異なる
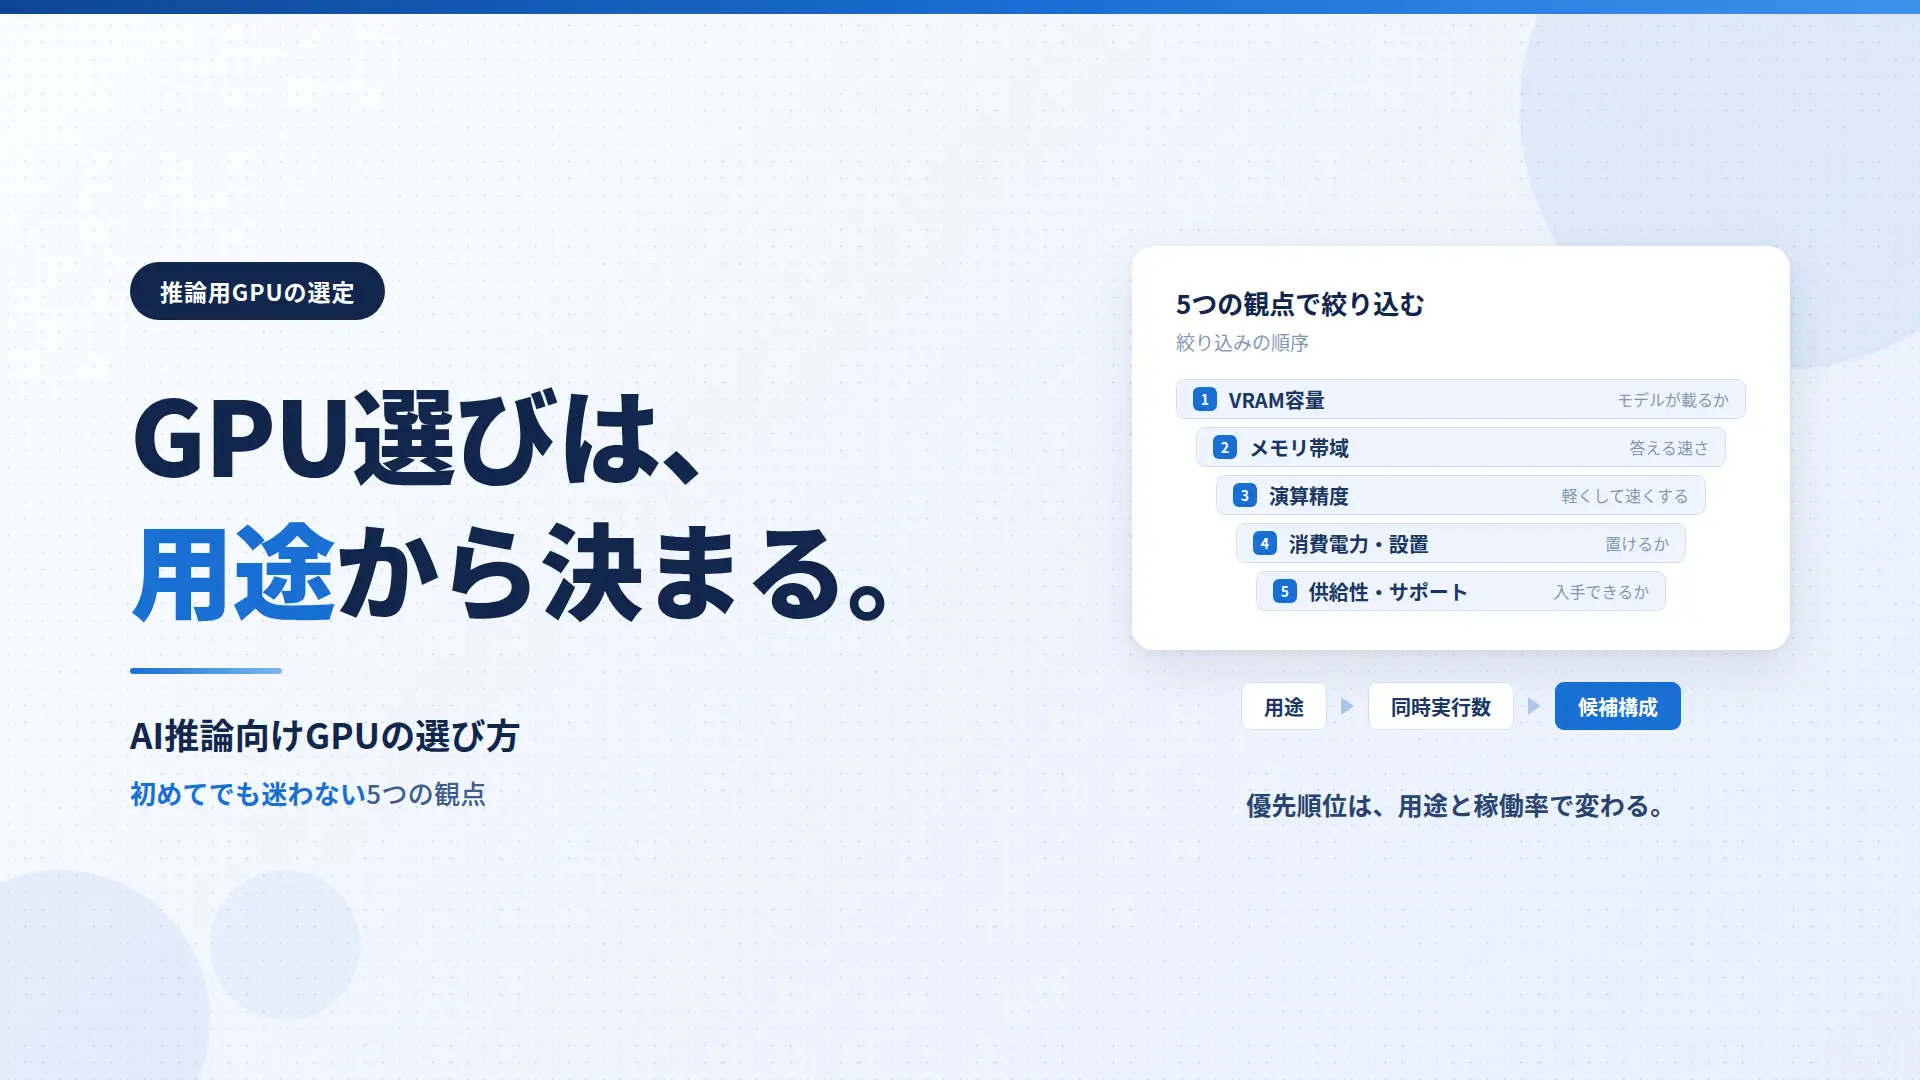
- VRAM・メモリ帯域・演算精度・消費電力・供給性の5つの観点で絞り込む
- 用途と稼働率によって、優先すべき観点は変わる
AIを業務で使おうとしたとき、多くの担当者が最初につまずくのが「どのGPUを選べばよいのか」という問題です。製品名や型番を調べても、カタログに並ぶ数値が自分の用途にどう関係するのかが見えにくい。結果として「とりあえず新しくて速いものを」という判断になりがちですが、それでは費用が過剰になったり、逆に必要な性能が出なかったりします。
まず「AIの推論とは何か」から整理し、そのうえでGPUを絞り込むための5つの観点を、専門用語をひとつずつ補いながら解説します。型番を暗記する必要はありません。何を基準に候補を絞ればよいかを持ち帰っていただくことが目的です。
- AIの「推論」とは何か、なぜGPUが必要になるのか
- GPUを選ぶときに見る5つの観点と、その意味
- 用途別の優先順位と、費用を見るときの考え方
そもそもAIの「推論」とは何か
GPUの話に入る前に、「推論」という言葉を整理しておきます。ここを押さえておくと、後半の観点がぐっと理解しやすくなります。
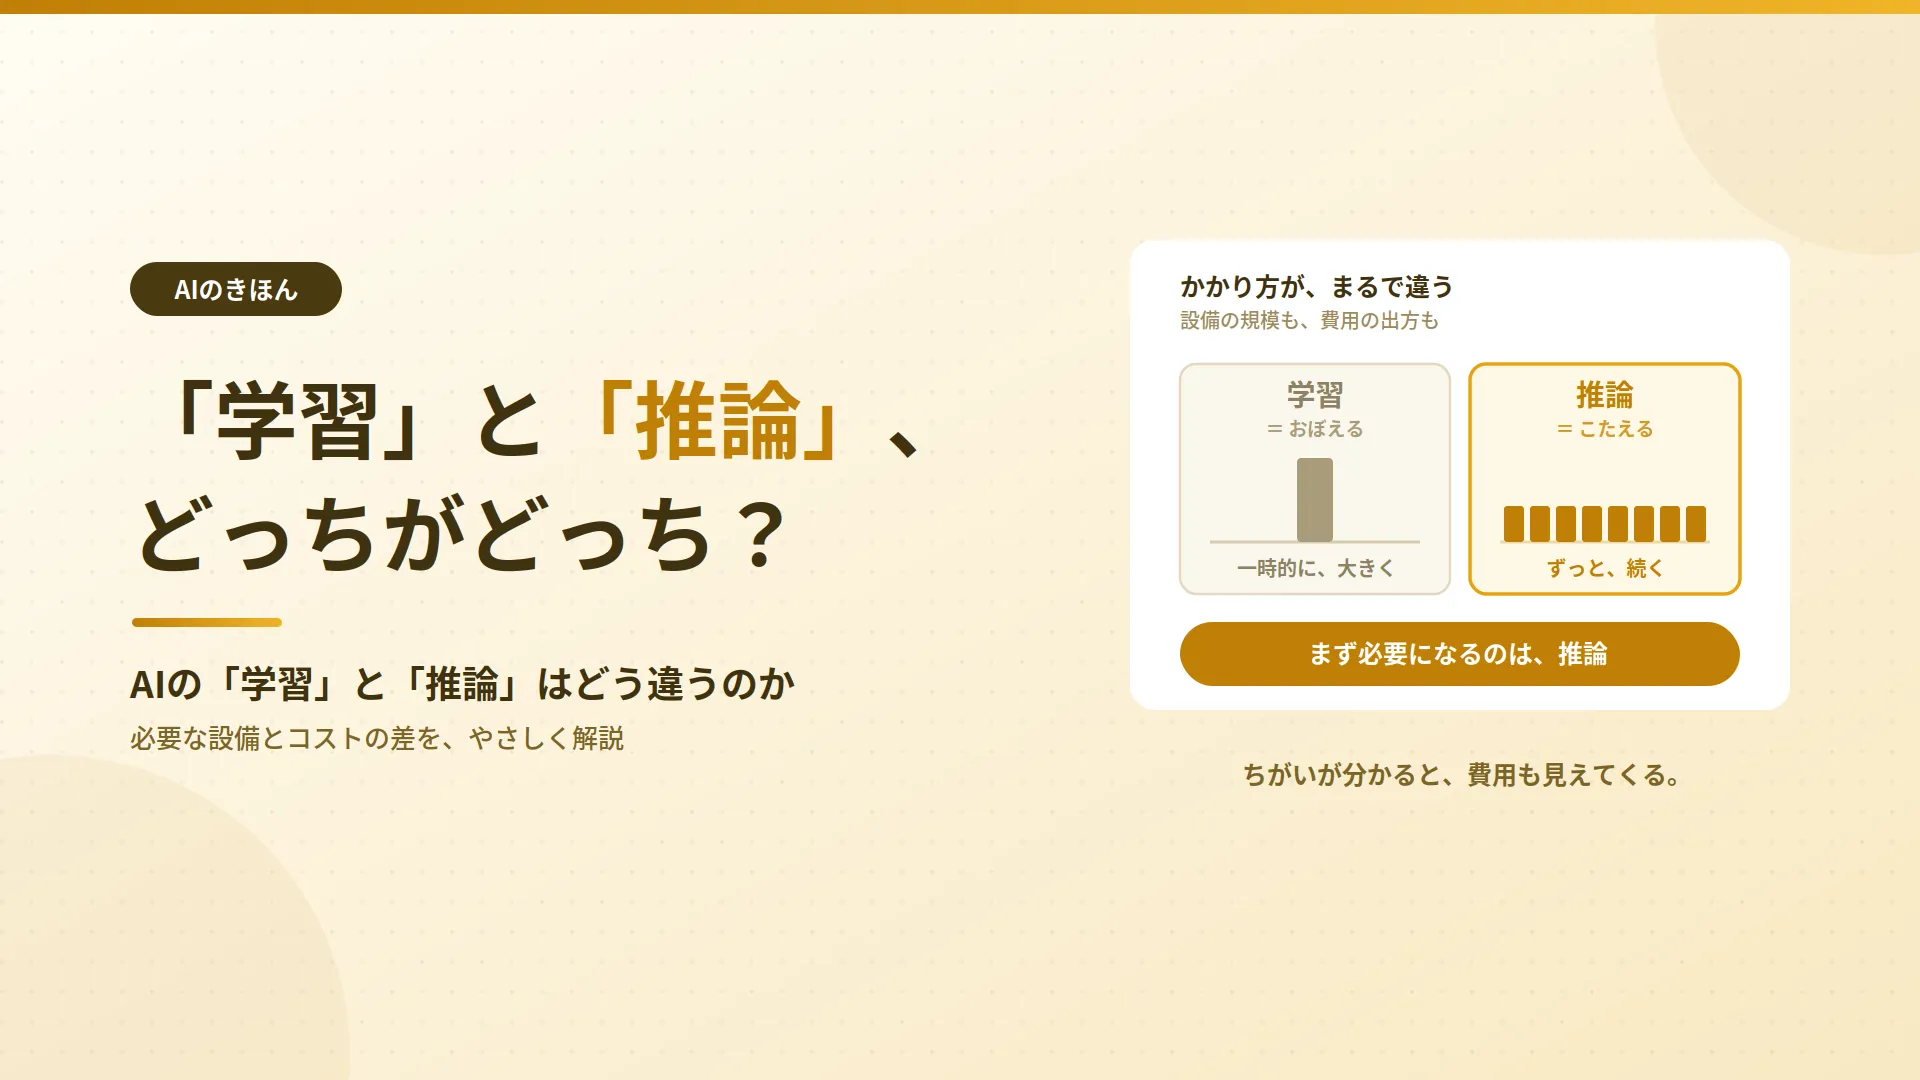
学習は「AIを作る」、推論は「AIを使う」
AIの処理は、大きく2つの段階に分かれます。
- 学習: 大量のデータを読み込ませて、AIモデルそのものを作る段階
- 推論: できあがったモデルに質問や画像を渡して、答えを出させる段階
推論 用語解説 学習済みのAIモデルに入力を与えて、出力を得る処理。チャットに質問を入力して回答が返るまでの計算がこれにあたる。 は、日常的に触れているAIの動きそのものを指します。チャットに質問を打ち込んで回答が返ってくる、社内文書を検索して要約が出てくる。こうした処理はすべて推論です。
一方、 学習 用語解説 大量のデータからAIモデルのパラメータを調整し、モデル自体を作り上げる処理。推論より大規模な計算資源を一定期間まとめて必要とする。 はモデルを作る側の処理であり、多くの企業が自前で行うわけではありません。既存のモデルを使って業務に組み込む、つまり推論だけを自社で動かすというケースが実際には多くなります。
なぜ「使うだけ」でもGPUが必要なのか
「モデルを作るなら大変そうだが、使うだけなら普通のサーバーで足りるのでは」と思われるかもしれません。しかし、推論も1回の応答ごとに膨大な計算を必要とします。
生成AIが文章を返すとき、内部では次に来る単語を1つずつ予測する計算が繰り返されています。数百文字の回答を返すだけでも、この計算が何百回も走る。しかも1回あたりの計算では、モデルが持つ大量の数値データを読み出して掛け合わせる処理が発生します。この「大量の単純計算を同時にこなす」用途が、GPUの得意分野です。
学習の需要は一時的かつ大規模に発生しやすく、推論の需要は利用者数や処理件数に応じて継続的に積み上がります。性質が異なるため、必要なGPUの種類も契約形態も分けて考えることが前提です。
GPUクラウドという形で計算資源を借りる選択肢もあります。市場全体の動きや国内の供給事情については、生成AI向けGPUクラウドの市場動向と国内需要で整理しています。
推論用GPUの選定でつまずく3つの理由
「推論にGPUが要る」と分かっても、そこから製品を決める段階で手が止まります。理由は主に3つです。
いちばん新しくて速いGPUを選んでおけば、間違いないですよね?
そうとは限りません。 速さの前に「モデルが載るか」「置ける場所があるか」「そもそも入手できるか」を先に確認します。
第一に、型番が多く、世代と用途の違いが見えにくいという問題があります。GPUには学習向けに設計されたもの、推論向けに絞ったもの、映像処理も兼ねるものがあり、名前だけでは区別がつきません。
第二に、カタログの数値が自分の用途にどう効くのかが結びつかない点です。メモリ容量や演算性能の数字が並んでいても、「自分が使いたいモデルが動くのか」「何人が同時に使えるのか」という問いには直接答えてくれません。
第三に、性能以外の条件が後から判明するという落とし穴があります。GPUを決めた後で、電源容量が足りない、冷却が追いつかない、そもそも希望の製品が数か月待ちだった。こうした事情は性能表には載っていません。
- GPUは名前だけでは学習向けか推論向けかを判別しにくい
- カタログ値と自社の用途を結び付ける視点が必要
- 電力・設置条件・入手性は性能表に載っていない
GPUを選ぶときに見る5つの観点
ここからが本題です。推論用GPUを絞り込むときに見る観点は、大きく5つに整理できます。全体像は次のとおり。
推論用GPUを見る5つの観点
① VRAM容量
モデルが載るかどうかを決める。足りなければ動かない。
② メモリ帯域
どれだけ速く答えられるかを決める。推論では効きやすい。
③ 演算精度への対応
軽くして速くする余地があるかを決める。
④ 消費電力と設置条件
置ける場所があるかを決める。電源と冷却の制約。
⑤ 供給性とサポート期間
そもそも入手できるか、いつまで使えるかを決める。
一般的な整理例です。実際の案件では要件によって重み付けが変わります。
① VRAM容量 ─ 「モデルが載るか」を決める
ひとことで言うと、最初の関門です。 ここが足りないと、性能の話に進む前に動きません。
VRAM 用語解説 GPUに搭載された専用メモリ。推論時はAIモデルのデータをここに読み込むため、容量がモデルサイズの上限を決める。 は、GPUが持つ専用のメモリです。推論を実行するには、使いたいAIモデルのデータをこのVRAMに読み込む必要があります。つまりVRAM容量がモデルサイズの上限になります。容量を超えるモデルは、単純に載りません。
ただし、モデルのサイズは固定ではありません。 量子化 用語解説 モデル内部の数値をより少ないビット数で表現し、必要なメモリ量と計算量を減らす手法。出力品質に影響する場合がある。 という手法を使うと、モデルが持つ数値の表現を粗くすることで、必要なVRAM量を減らせます。同じモデルでも、量子化の条件によって必要な容量は変わる。したがって「モデル名だけでVRAMが決まる」わけではありません。
量子化による品質への影響はモデルや用途によって異なります。適用する場合は、想定する業務での出力品質を個別に検証することが前提です。
もう一点、見落としやすいのが同時実行数です。複数の利用者が同時にリクエストを送ると、処理中のデータを保持する分だけVRAMを追加で消費します。モデル本体が載るだけでは足りません。想定する同時実行数を踏まえて逆算する必要があります。
② メモリ帯域 ─ 「どれだけ速く答えられるか」を決める
ひとことで言うと、体感速度に直結する観点です。
メモリ帯域 用語解説 GPUがVRAMとの間で1秒間にやり取りできるデータ量。単位はGB/sなど。 は、GPUがVRAMからデータを読み出す速さを表します。カタログでは演算性能の数値が目立ちますが、推論では帯域のほうが効きやすい場面が多くあります。
理由は処理の性質にあります。生成AIが単語を1つ予測するたびに、モデルが持つ大量の数値を読み出す必要がある。計算そのものは単純でも、読み出しの量が膨大なため、演算装置がデータの到着を待つ状態になりやすいのです。この待ち時間を短くするのが帯域です。
演算性能が高くても帯域が伴わなければ、推論の応答速度は伸び切りません。「演算性能の数値が大きいほど推論が速い」とは限らない、と押さえておくと判断を誤りにくくなります。
なお、これは推論の一般的な傾向です。処理内容やモデルの構造によって支配的な要因は変わるため、すべての用途に当てはめられるわけではありません。
③ 演算精度への対応 ─ 「軽くして速くする」余地
ひとことで言うと、同じGPUからどれだけ効率を引き出せるかの余地です。
AIの計算で扱う数値には、FP16、BF16、FP8、INT8といった表現方式があり、これらは数値を何ビットで表すかの違いを指します。ビット数を減らすほど、必要なメモリ量が減り、処理も速くなります。
- ビット数が多い: 精度を保ちやすいが、メモリと計算量を多く使う
- ビット数が少ない: メモリと計算量を抑えられるが、出力品質に影響し得る
重要なのは、どの方式に対応しているかがGPUの世代によって異なる点です。より少ないビット数での計算に対応した世代であれば、同じモデルをより軽く速く動かせる可能性があり、逆に古い世代では効率化の手段が限られます。
ビット数を減らすと出力品質が変わる可能性があります。影響の程度はモデル、用途、入力内容によって異なるため、一律の基準は示せません。業務で使う前に、実際の入力で品質を確認する工程を組み込んでください。
④ 消費電力と設置条件 ─ 「置ける場所があるか」を決める
ひとことで言うと、性能以前の物理的な制約です。 ここを飛ばすと、GPUを買った後で設置できないという事態が起こります。
GPUは従来のサーバー用途に比べて消費電力が大きく、台数が増えるほど必要な電力と冷却能力が膨らみます。確認すべきは主に3点です。
- 電源容量: ラック単位で供給できる電力の上限に収まるか
- 冷却能力: 発熱を処理できるか。空冷で足りるか、液冷が必要か
- 設置スペース: 筐体サイズと、必要な台数が収まるか
自社でサーバーを持つ場合はもちろん、データセンターに預ける場合も、施設側の受け入れ条件を先に確認する必要があります。「ラックは借りられるが、そのラックに供給できる電力が足りない」というケースは珍しくありません。
電力需要が増える背景と、エネルギー面の制約については、生成AIの電力需要はなぜ急増するのか|データセンターとエネルギー制約で詳しく整理しています。総務省の資料でも、生成AIの普及にともなうデータセンター向け電力需要の増加と、電力と計算資源を一体で考える必要性が指摘されています。同資料はさらに、現時点で大きいのは学習時の電力消費である一方、2040年には推論時の電力消費が支配的になるとの見通しを示しました。推論を継続的に動かすのであれば、電力は導入時に一度確認して終わる項目ではなく、運用期間を通じた前提条件になります。
出典: 総務省「生成AIの電力消費拡大にどう対応すべきか - ワット・ビット連携の実現に向けて」(2025年2月)。電力需要の見通しは前提条件により変動します。
⑤ 供給性とサポート期間 ─ 「そもそも入手できるか」を決める
ひとことで言うと、計画が成立するかを左右する観点です。
性能面で最適な製品を選んでも、必要な時期に手に入らなければ計画は進みません。AI向けGPUの需要が拡大している局面では、希望する製品に調達リードタイムが生じることがあります。確認しておきたいのは次の点です。
- 調達リードタイム: 発注から納品までどれくらいかかるか
- 代替構成: 第一候補が確保できない場合に、次に何を選ぶか
- サポート期間: 保守や部品供給がいつまで受けられるか
- 後継世代の見通し: 導入直後に世代交代が起きる時期ではないか
リードタイムの長さは製品や時期によって変わります。ただし規模感の目安はあり、NVIDIAは年次報告書のリスク要因として、製造リードタイムが長く、一部の製品では12か月を超えて延びた実績があると開示しました。調達計画では、こうした期間が生じ得る前提で逆算しておくと後戻りを避けやすくなります。
出典: NVIDIA Corporation「Form 10-K」(2026年1月25日終了会計年度)。リードタイムは製品、時期、市況によって変動します。
特定の型番に固定して計画を立てると、確保できなかった時点で全体が止まります。複数の候補構成を用意しておくという考え方が、実務では現実的です。
- VRAMはモデル本体+同時実行分で逆算する
- 推論では演算性能よりメモリ帯域が効きやすい
- 電力・冷却・設置条件は性能検討の前に確認する
- 第一候補が取れない前提で代替構成を用意する
用途別に見る、優先順位の付け方
5つの観点をすべて最高水準で満たす必要はありません。用途によって、優先すべき観点が変わります。代表的な3パターンで整理します。
社内で少人数が大きいモデルを使う場合
研究開発や専門部署での利用など、利用者が限られる一方で扱うモデルが大きいケース。この場合はVRAM容量が最優先になります。同時実行数が少ないため帯域の要求は相対的に緩く、まず「モデルが載ること」を満たす構成を探すことになります。
多数の利用者が同時に使う場合
全社向けのチャットボットや、顧客対応に組み込む用途。ここではメモリ帯域と、まとめて処理する効率が重要になります。同時リクエストを束ねて処理する方式を前提に、応答時間の目標を先に決めてから必要な構成を見積もる流れが現実的です。加えて、同時実行分のVRAM消費を見込んでおくことも欠かせません。
業務システムに常時組み込む場合
基幹業務の一部として、24時間稼働させるケースです。この場合は稼働率と電力コストの比重が上がります。常時動かすなら電力費が継続的に積み上がるため、性能あたりの消費電力が判断材料になる。また、保守体制やサポート期間といった長期の運用条件も重みを増します。
いずれも一般的な整理であり、実案件では扱うデータの要件や既存環境によって優先順位が変わります。
費用は「GPUの値段」だけでは決まらない
選定の最後に費用の話をします。ここで誤解が起きやすいのは、GPU本体の価格や時間単価だけを比べてしまうことです。
本体価格・利用料・電力の3層で見る
費用は、少なくとも3つの層に分けて考える必要があります。
費用を構成する3つの層
取得費用
自社で保有する場合の本体価格と、サーバー・ネットワーク側の付帯費用。
利用料
GPUクラウドを使う場合の時間単価や予約料金。データ転送料が別建ての場合もある。
運用費用
電力、冷却、設置場所、保守。常時稼働では継続的に積み上がる。
※ 料金体系や課金対象の範囲は事業者、契約プラン、リージョンによって異なり、変動します。比較する際は確認時点を記録してください。
稼働率によって結論が変わる
保有とクラウド利用のどちらが適するかは、稼働率によって入れ替わります。稼働率が高く安定して見込める用途なら、保有したほうが総額を抑えられる場合もある。逆に需要の変動が大きい用途や、まだ規模が読めない検証段階では、必要な分だけ借りられる柔軟性が生きます。
したがって、費用を比べる前に「どれくらいの頻度で、どれくらいの期間使うのか」を見積もることが先です。ここが曖昧なままでは、どの料金体系が有利かも判断できません。
初めての選定で見落としやすい注意点
カタログの数値だけでは判断しきれません。使いたいモデルやフレームワークがそのGPUに対応しているか、必要なドライバやソフトウェアが揃うかは別に確認が必要です。また、検証時点で確認した条件をそのまま本番に当てはめないでください。同時実行数や稼働時間が変われば、必要な構成も費用の出方も変わります。
もう一点補足すると、ソフトウェア面の対応状況は選定結果を左右します。GPUの世代が新しくても、使いたいツールがまだ対応していなければ本番投入は難しい。逆に、実績のある世代であれば情報が豊富で、運用時のトラブルシューティングも進めやすくなります。性能の数値だけでなく、周辺の情報とツールが揃っているかも判断材料に含めてください。
そのまま使える選定チェックリスト
社内の検討やベンダーへの確認にそのまま持ち込める形で、確認項目を整理します。
- 用途と同時実行数を先に決めたか
- 使いたいモデルから必要なVRAM量を逆算したか(同時実行分を含む)
- 量子化を前提にする場合、出力品質の検証工程を組み込んだか
- 応答時間の目標値を決めたうえで、メモリ帯域の観点を確認したか
- 電源容量・冷却・設置スペースの受け入れ条件を施設側に確認したか
- 調達リードタイムと、確保できない場合の代替構成を用意したか
- 保守期間と後継世代の見通しを確認したか
- 費用を取得費用・利用料・運用費用の3層で見積もったか
- 想定する稼働率をもとに、保有と借用を比較したか
- 使いたいフレームワークやツールの対応状況を確認したか
- 比較した数値の確認時点を記録したか
AIインフラの選定・調達を検討するなら
ここまで整理してきたとおり、推論用GPUの選定は製品比較だけでは完結しません。用途から必要な容量を逆算し、電力と設置条件を確認し、調達の見通しを立て、そのうえで費用を比較する。この一連の流れを順に進めることが、後戻りを防ぐ前提になります。
こうした論点を整理する具体的な手段として、イオレのAIインフラ事業では、容量設計・運用設計・調達整理の観点から検討を支援しています。一般的な判断軸を踏まえたうえで、用途に応じた構成の絞り込みや確保の進め方を整理する位置づけです。
※ 支援の範囲や前提条件は案件により異なります。特定製品の供給や性能を保証するものではありません。詳細は問い合わせ導線からご確認ください。
関連する相談導線
AIインフラ支援の考え方を見る 容量設計・運用設計・調達整理の観点を確認まとめ
AI推論向けのGPUは、学習用とは求められる条件が異なります。「新しくて速いもの」を選べば済むわけではなく、まず使いたいモデルが載るかどうか、そして必要な速度が出るかどうかを分けて考えることが出発点です。
絞り込みの観点は、VRAM容量、メモリ帯域、演算精度への対応、消費電力と設置条件、供給性とサポート期間の5つ。このうちどれを優先するかは用途によって変わり、少人数で大きいモデルを使うならVRAM、多数が同時に使うなら帯域と処理効率、常時稼働なら稼働率と電力が中心になります。
費用は本体価格や時間単価だけでなく、運用にかかる電力や保守まで含めて見る。そして仕様や料金は変動するため、確認時点を記録して判断することが、見落としを防ぐ前提です。
- 推論用GPUは学習用と別の基準で選ぶ
- VRAM・帯域・精度・電力・供給性の5観点で絞り込む
- 優先順位は用途と稼働率によって変わる
- 費用は取得・利用・運用の3層で見積もり、確認時点を記録する